RAG (Retrieval-Augmented Generation), bir büyük dil modelinin (LLM) yanıt üretmeden önce soruyla ilgili bilgiyi harici bir kaynaktan bulup getirmesi ve yanıtını bu bilgiye dayandırmasıdır. Türkçede “getirmeyle zenginleştirilmiş üretim” olarak çevrilir. Model yeniden eğitilmez: bilgi tabanı güncellendiğinde yanıtlar da güncellenir.
Bu rehberde RAG’in ne olduğunu, neyin kısaltması olduğunu, LLM’lerle nasıl çalıştığını, RAG mimarisini ve bileşenlerini, fine-tuning ile farkını ve bir RAG sisteminin adım adım nasıl kurulduğunu anlatıyoruz. Sonda en sık sorulan soruların kısa yanıtları var.
RAG Nedir ve Neyin Kısaltmasıdır?
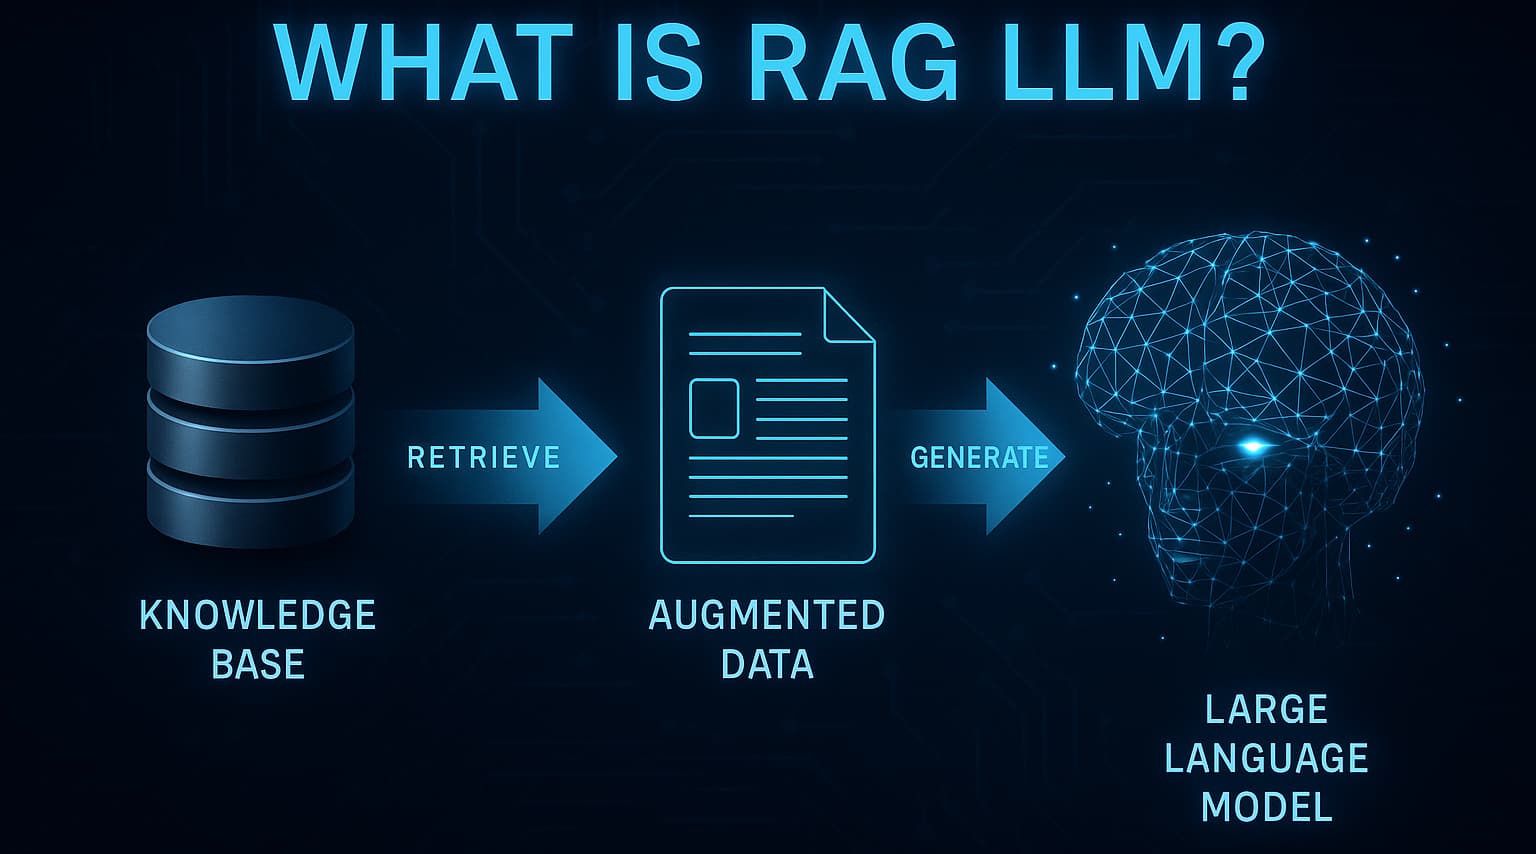
RAG, İngilizce Retrieval-Augmented Generation ifadesinin kısaltmasıdır: Retrieval (getirme), Augmented (zenginleştirilmiş), Generation (üretim). Yani model, önce ilgili bilgiyi getirir, istemini bu bilgiyle zenginleştirir, sonra yanıtı üretir.
Bu yaklaşım, bilgi getirme sistemlerinin (ilgili veriyi bulma) gücünü LLM’lerin metin üretme yeteneğiyle birleştirir. Böylece LLM yalnızca eğitildiği veriyle sınırlı kalmaz; şirket dokümanları, ürün veritabanı ya da güncel web içeriği gibi kaynaklardan sorguya özel bilgi çekerek bağlama uygun, güncel ve kaynağı gösterilebilir yanıtlar verir.
LLM Nedir? RAG’i Anlamak İçin Kısa Bir Not
LLM (Large Language Model, büyük dil modeli), çok büyük metin veri kümeleriyle eğitilmiş ve bir metindeki bir sonraki kelimeyi (token) tahmin ederek dil üreten yapay zekâ modelidir. ChatGPT’nin arkasındaki GPT modelleri, Claude, Gemini ve Llama bu sınıfa girer.
LLM’lerin bilgisi eğitim verisinin kesildiği tarihte donar ve modelin parametrelerine gömülüdür. Model bir konuyu bilmiyorsa çoğu zaman “bilmiyorum” demek yerine ikna edici bir tahmin üretir. RAG tam olarak bu iki sınırı, yani bayat bilgiyi ve uydurma yanıtı hedefler.
RAG Tabanlı Ne Demek?
“RAG tabanlı” bir sistem, yanıtlarını modelin hafızasından değil, her soruda kendi bilgi tabanından getirdiği içerikten üreten sistemdir. Örneğin RAG tabanlı bir chatbot, bir müşterinin sorusunu yanıtlamadan önce şirketin güncel yardım makalelerini ve fiyat listesini arar; yanıtı bu belgelere dayandırır ve çoğu zaman hangi belgeden aldığını da gösterir.
RAG’in LLM’lerde Çözdüğü Temel Sorunlar
RAG, LLM’lerin bazı temel kısıtlarını aşarak yapay zekâyı gerçek iş senaryolarına uygun hâle getirir:
- Halüsinasyonlar (Uydurma Bilgi): LLM’ler bazen gerçekte olmayan ama ikna edici görünen bilgiler üretir. RAG, dış kaynaklardan alınan doğrulanabilir verilerle bu riski önemli ölçüde azaltır.
- Güncellik Sorunu: LLM’ler, sabit veri kümeleriyle eğitildiğinden güncel bilgilere erişemez. RAG, sorgu anında güncel veri çekerek bu sınırlamayı ortadan kaldırır.
- Alan Uzmanlığı Eksikliği: Standart LLM’ler özel alanlara ait içeriklere hâkim değildir. RAG, sektöre özgü ya da uzmanlık gerektiren bilgileri modele sunarak, bu eksikliği giderir.
- Şeffaflık Eksikliği: RAG ile üretilen yanıtların hangi kaynaklara dayandığı görülebilir. Bu da hem kurumsal kullanımlar hem de kullanıcı güveni açısından büyük avantaj sağlar.
RAG Nasıl Çalışır? 4 Adımda Mekanizma
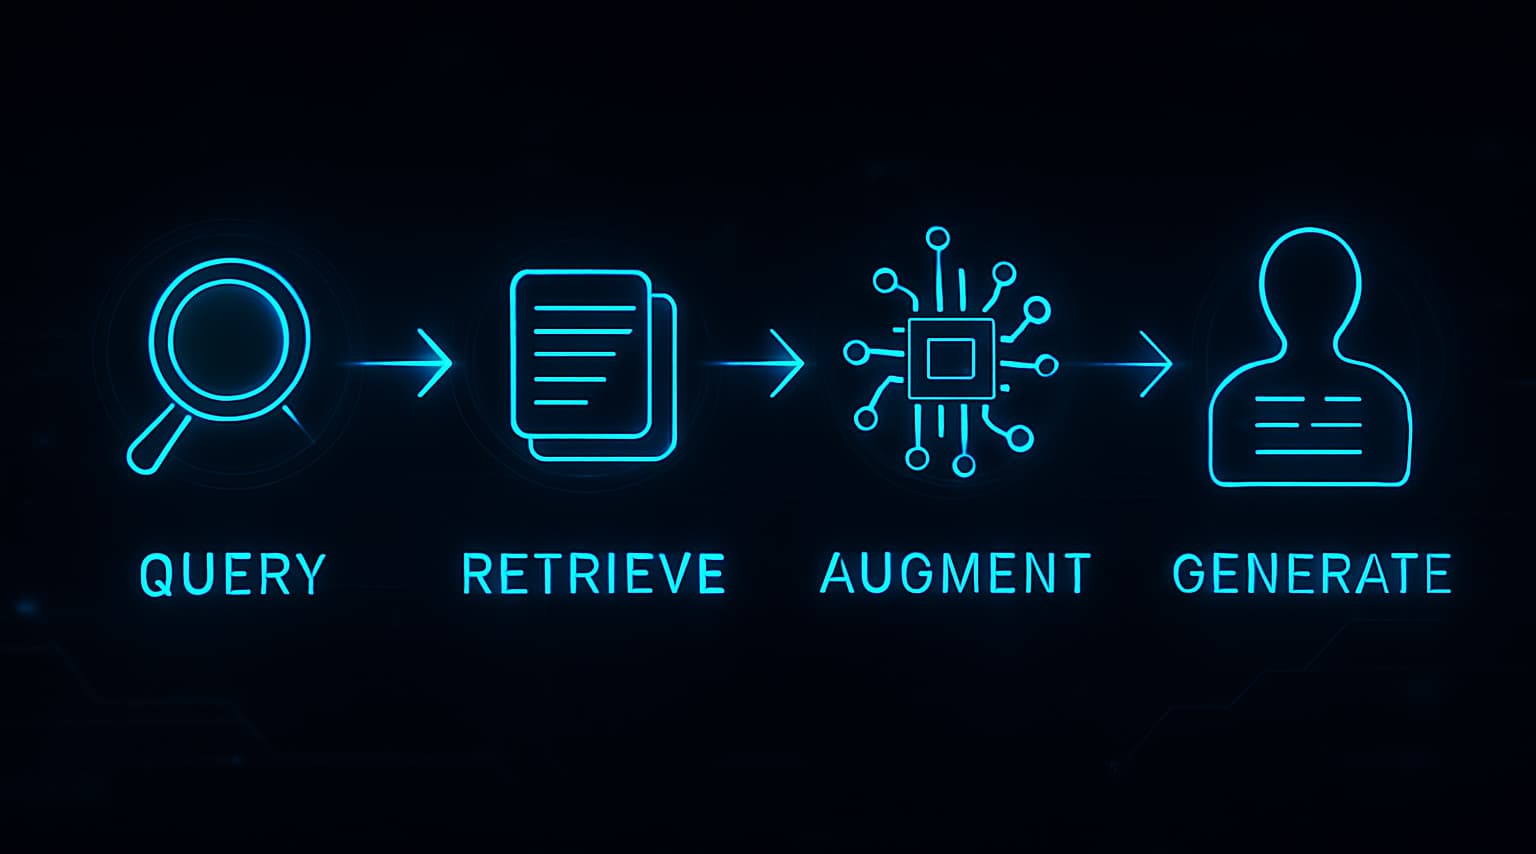
Bir RAG sisteminin her soruda izlediği akış dört adımdan oluşur:
- Kullanıcı Sorgusunun Alınması: Süreç, kullanıcının bir soru ya da istem göndermesiyle başlar.
- Bilgi Getirme (Retrieval): Sistem, dış bilgi kaynaklarında (veritabanları, doküman havuzları, halka açık web verileri) sorguyla ilgili belge ya da veri parçalarını arar. Bu işlem genellikle belgelerin vektör temsillere (embedding) dönüştürülmesi ve anlamsal benzerlik aramalarıyla yapılır.
- Bağlam Zenginleştirme: Elde edilen veriler, kullanıcı sorgusuyla birleştirilerek LLM’ye gönderilecek gelişmiş bir istem oluşturulur. Bu, modele doğrudan bağlam kazandırır.
- Yanıt Üretimi: LLM, bu artırılmış istemi işler ve artık sadece kendi iç bilgisini değil, dışarıdan alınmış güncel ve alakalı verileri de kullanarak yanıt üretir.
ChatGPT, Perplexity ya da Google’ın AI Overviews özelliği bir soruyu yanıtlarken web’den kaynak getirdiğinde de aynı mantık işler. Bu yüzden içeriğinizin bu sistemler tarafından bulunup alıntılanması, GEO (Generative Engine Optimization) çalışmalarının konusudur.
ChatGPT Bir RAG Sistemi mi?
Tek başına hayır. ChatGPT’nin arkasındaki model, yalnızca eğitim verisiyle yanıt verdiğinde bir LLM’dir. Web araması açıkken ya da yüklediğiniz dosyalar üzerinden yanıt verirken ise önce ilgili içeriği getirir ve yanıtını ona dayandırır; bu akış RAG’dir. Kısacası RAG bir model değil, modelin etrafına kurulan bir mimaridir.
Temel Avantajlar: RAG LLM Performansını Nasıl Artırır?
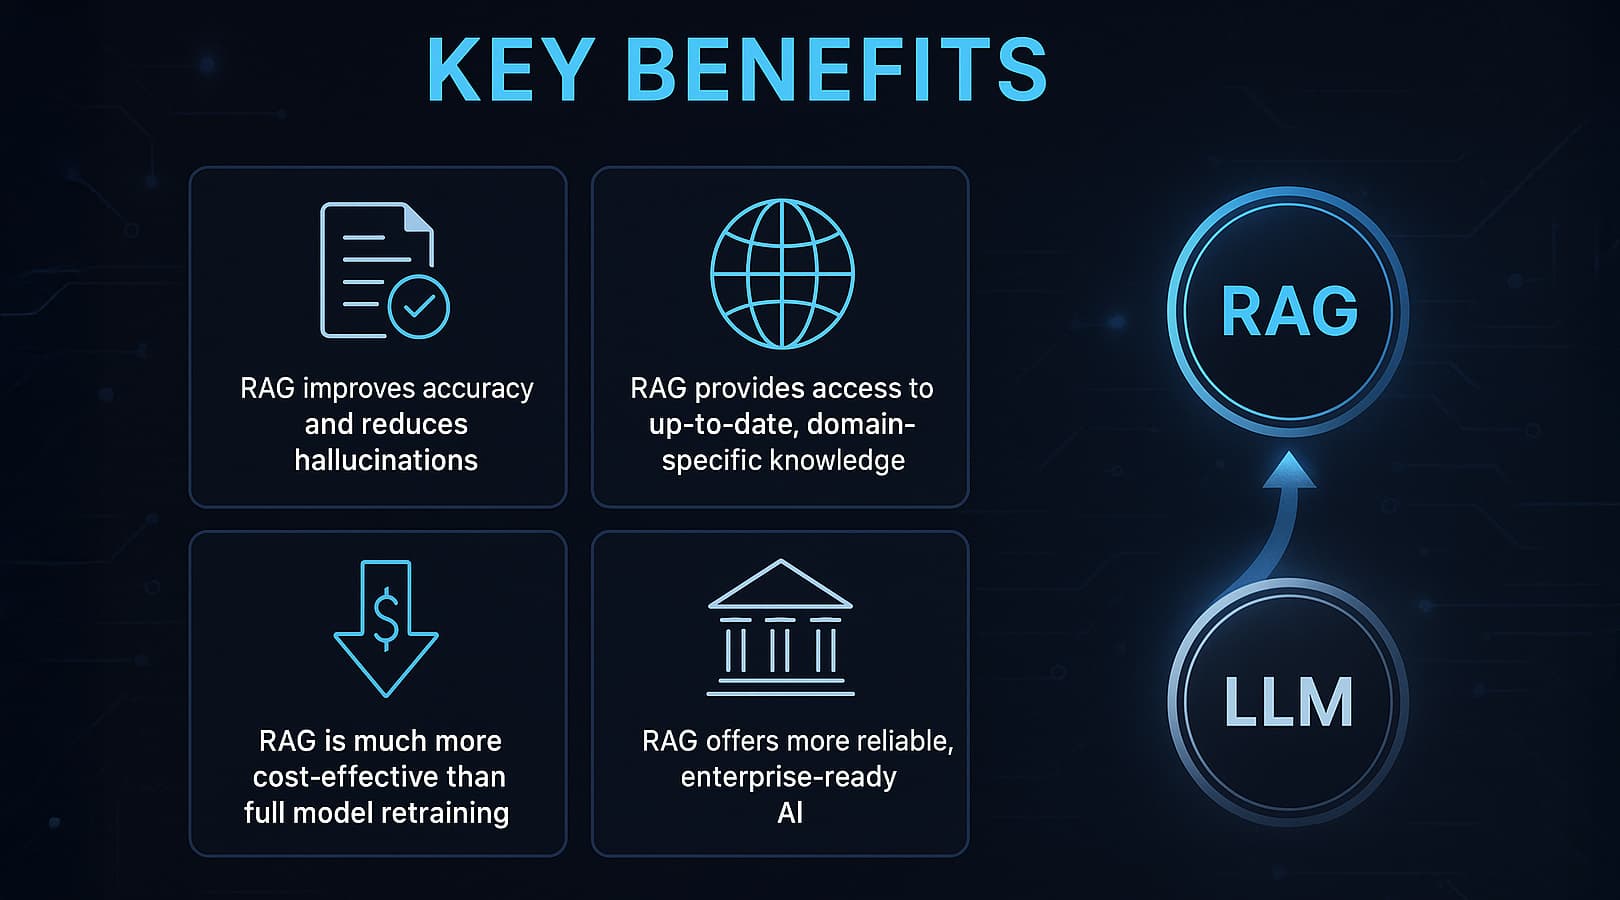
RAG yaklaşımı, LLM tabanlı sistemleri daha doğru, güncel ve denetlenebilir hâle getirdiği için kurumsal yapay zekâ projelerinde varsayılan mimarilerden biri hâline geldi.
Doğruluğu Artırır, Halüsinasyonu Azaltır
RAG, LLM’lere sorgu anında doğrulanabilir “dayanak verisi” (grounding data) sağlar. Model yalnızca parametrik belleğine güvenmek yerine önündeki belgelerden yanıt üretir; bu da uydurma bilgi riskini belirgin biçimde azaltır. Risk sıfırlanmaz: getirilen belge yanlış ya da alakasızsa yanıt da zayıf olur.
RAG Güncel ve Alan-Spesifik Bilgiye Erişim Sağlar
RAG kullanan sistemler, yalnızca modelin eğitim tarihine kadar olan bilgilerle sınırlı kalmaz. Haber özeti oluşturma, finansal analiz ya da sektöre özgü içerik üretimi gibi güncel veri gerektiren uygulamalarda bu özellik büyük avantaj sağlar. Ayrıca kurum içi özel dokümanlara, sürekli güncellenen teknik bilgilere veya uzmanlık gerektiren içeriklere erişim imkânı sunarak, RAG’i kurumsal çözümler için vazgeçilmez kılar.
RAG, Modeli Yeniden Eğitmeden Bilgiyi Günceller
Bir LLM’nin bilgi altyapısını güncellemenin geleneksel yolu, yeniden eğitimdir. Ancak bu süreç oldukça maliyetli, zaman alıcı ve teknik olarak karmaşıktır. RAG yaklaşımı ise yalnızca harici bilgi kaynağının güncellenmesiyle yeni verileri sisteme entegre etmeyi mümkün kılar. Bu yöntem hem çok daha düşük maliyetlidir hem de modeli yeniden eğitmeden güncel bilgiyi devreye almayı sağlar. Bu yönüyle, özellikle sık veri güncellemesi gereken sektörlerde RAG’in benimsenmesi hızla artmaktadır.
RAG, Güvenilir ve Kurumsal Ölçekte Yapay Zekâ Sunar
Üretken yapay zekâ (GenAI – generative AI) sistemlerinin kurumsal alanda kullanılabilmesi için üretilen bilgilerin doğruluğu, güncelliği ve kaynak güvenilirliği tartışmasız olmalıdır. RAG, bu gereksinimleri karşılayarak yapay zekâ sistemlerinin güvenilirliğini ve benimsenebilirliğini artırır. Böylece kurumlar, hesap verebilirlik ve doğruluk kriterlerine uygun, denetlenebilir yapay zekâ uygulamaları geliştirme yolunda önemli bir adım atmış olur.
RAG Mimarisi: Bileşenler ve Tipik Pipeline
RAG sistemlerini kurmak, değerlendirmek veya mevcut yapılarla entegre etmek isteyenler için mimariyi anlamak kritik önemdedir. İngilizce kaynaklarda bu yapı “RAG architecture” veya “RAG pipeline” olarak geçer.
Tipik Bir RAG Pipeline Nasıl İşler?
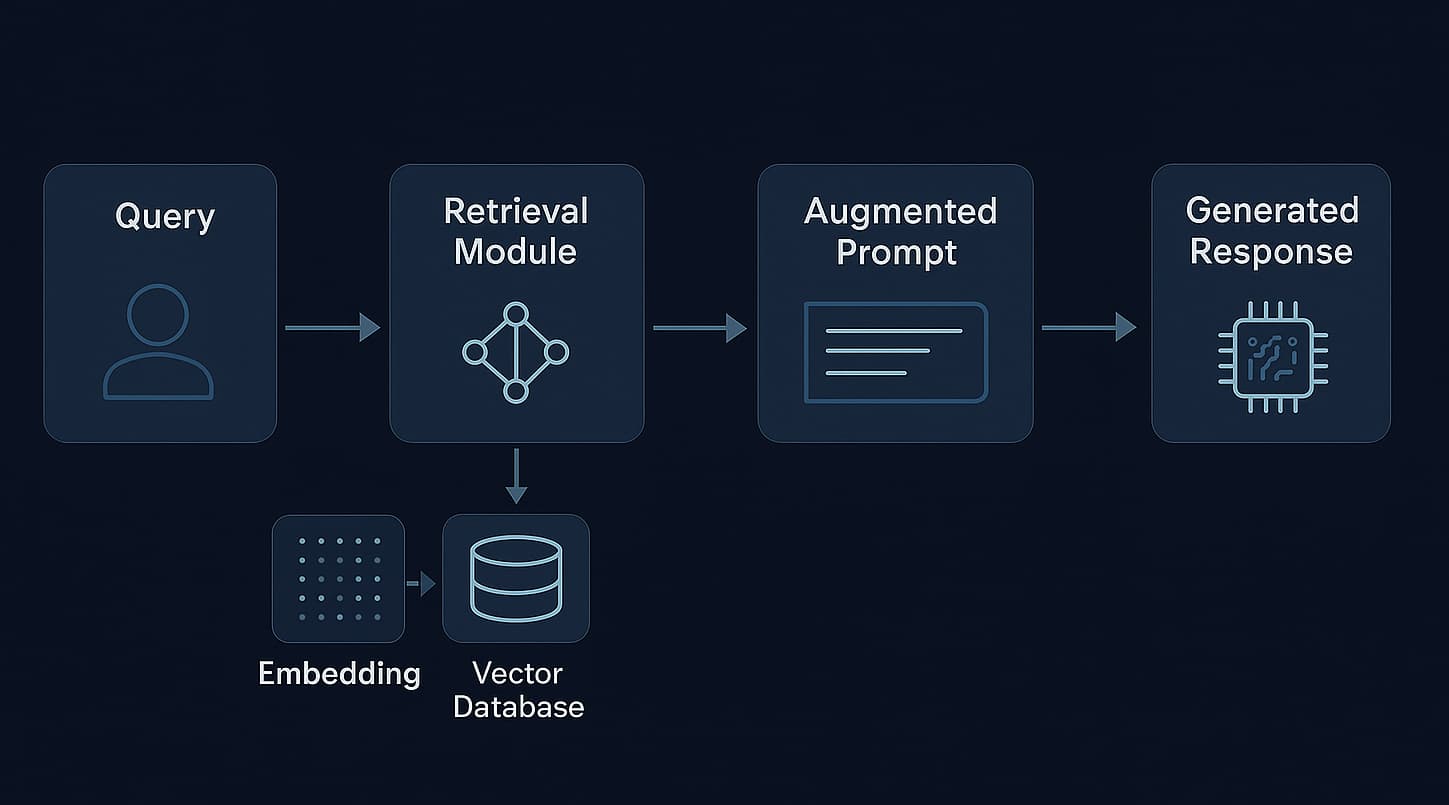
Standart bir RAG mimarisi, birbirine bağlı dört aşamadan oluşur. Her aşama kullanım senaryosuna göre tasarlanmalı ve ölçülerek iyileştirilmelidir:
- Veri toplama ve hazırlama (indeksleme): Dokümanlar, veritabanları ve API’lerden içerik toplanır, temizlenir ve küçük parçalara bölünür (chunking). Her parça bir embedding modeliyle sayısal vektöre dönüştürülür ve vektör veritabanına indekslenir.
- Getirme (retrieval): Kullanıcının sorusu aynı embedding modeliyle vektöre çevrilir. Sistem vektör veritabanında benzerlik araması (örneğin cosine similarity) yapar, gerekirse anahtar kelime aramasıyla birleştirir ve en alakalı parçaları sıralar.
- Bağlam zenginleştirme (augmentation): Seçilen parçalar, kullanıcının sorusu ve talimatlarla birlikte “zenginleştirilmiş istem” (augmented prompt) hâline getirilir. Parçaların sırası, formatı ve kaynak bilgisi bu aşamada belirlenir.
- Yanıt üretimi (generation): LLM, bu istemi işleyerek getirilen bağlama dayanan, tutarlı ve gerekiyorsa kaynak gösteren bir yanıt üretir.
Retrieval modülünün başarımı, RAG sisteminin genel doğruluğunu ve güvenilirliğini doğrudan etkiler.
RAG Sistemindeki Temel Bileşenler
Etkili bir RAG sistemi için aşağıdaki bileşenlerin her biri ihtiyaca göre seçilmelidir:
- Bilgi tabanı: RAG’in getirdiği her şeyin kaynağı. PDF ve Word dokümanları, wiki sayfaları, veritabanları, web siteleri ve API’ler olabilir. Kaynağın doğruluğu ve güncelliği sistemin tavanını belirler.
- Embedding modeli: Metni anlamı koruyacak şekilde vektöre çevirir. OpenAI text-embedding-3, Cohere Embed ya da BGE, E5 gibi açık kaynak modeller yaygın seçeneklerdir. Türkçe içerikte çok dilli bir model seçmek getirme kalitesini doğrudan etkiler.
- Vektör veritabanı: Embedding’lerin saklandığı ve sorgulandığı katman. Pinecone, Weaviate, Qdrant, Milvus, Chroma, FAISS veya mevcut PostgreSQL’e eklenen pgvector kullanılabilir. Seçim veri hacmine, gecikme hedefine ve altyapıya göre yapılır.
- Getirme ve yeniden sıralama: Basit benzerlik aramasından hibrit aramaya (anlamsal + anahtar kelime) ve reranker modelleriyle yeniden sıralamaya kadar uzanır. Kaliteyi en çok artıran halka genellikle budur.
- LLM: Soru ve getirilen bağlamla son yanıtı üretir. Yanıt kalitesini, hızı ve maliyeti doğrudan belirler.
Chunking: Belgeleri Doğru Parçalamak
Chunking, belgelerin getirilebilir küçük parçalara bölünmesidir. Parçalar çok büyükse alakasız metin bağlamı doldurur; çok küçükse cümleler anlamını kaybeder. Bu yüzden parça boyutu ve parçalar arası çakışma (overlap) veriye göre denenerek belirlenir.
- Strateji: Sabit boyutNasıl bölünür?: Belirli token sayısında, küçük bir çakışmaylaNe zaman uygun?: Hızlı başlangıç, düzensiz metinler
- Strateji: Yapıya göreNasıl bölünür?: Başlık, paragraf ve bölüm sınırlarındanNe zaman uygun?: Dokümantasyon, rehberler, sözleşmeler
- Strateji: AnlamsalNasıl bölünür?: Konu değiştiği noktada, embedding benzerliğiyleNe zaman uygun?: Uzun ve çok konulu belgeler
- Strateji: HiyerarşikNasıl bölünür?: Küçük parçalar aranır, üst bölümü bağlama verilirNe zaman uygun?: Hem kesin eşleşme hem bağlam gereken sorular
| Strateji | Nasıl bölünür? | Ne zaman uygun? |
|---|---|---|
| Sabit boyut | Belirli token sayısında, küçük bir çakışmayla | Hızlı başlangıç, düzensiz metinler |
| Yapıya göre | Başlık, paragraf ve bölüm sınırlarından | Dokümantasyon, rehberler, sözleşmeler |
| Anlamsal | Konu değiştiği noktada, embedding benzerliğiyle | Uzun ve çok konulu belgeler |
| Hiyerarşik | Küçük parçalar aranır, üst bölümü bağlama verilir | Hem kesin eşleşme hem bağlam gereken sorular |
RAG Yaklaşımları: Naif RAG’den Agentic RAG’e
RAG mimarisi hızla gelişiyor. Bugün kullanılan başlıca yaklaşımlar şunlar:
- Naif RAG: “Önce getir, sonra oku” mantığıyla çalışan en basit yapı. Kurulumu kolaydır; getirilen belgeler zayıfsa yanıt da zayıf olur.
- Gelişmiş RAG: Sorgu genişletme ve yeniden yazma, hibrit arama, yeniden sıralama ve bağlam sıkıştırma gibi ön ve son işlem adımları ekler.
- Modüler RAG: Getirici, bellek, reranker ve LLM gibi bileşenlerin bağımsız olarak değiştirilebildiği yapı. Uzun ömürlü kurumsal projeler için uygundur.
- GraphRAG: Belgelerdeki varlıkları ve ilişkileri bir bilgi grafiğine çıkarır. “Bu raporlardaki ana temalar neler?” gibi tüm koleksiyonu kapsayan sorularda düz vektör aramasından daha iyi sonuç verebilir.
- Agentic RAG: LLM bir ajan gibi davranır: ne zaman, nereden ve kaç kez bilgi getireceğine kendisi karar verir, sonucu yeterli bulmazsa sorguyu değiştirip yeniden arar.
RAG vs. Fine-Tuning: Hangi Yaklaşım Size Uygun?
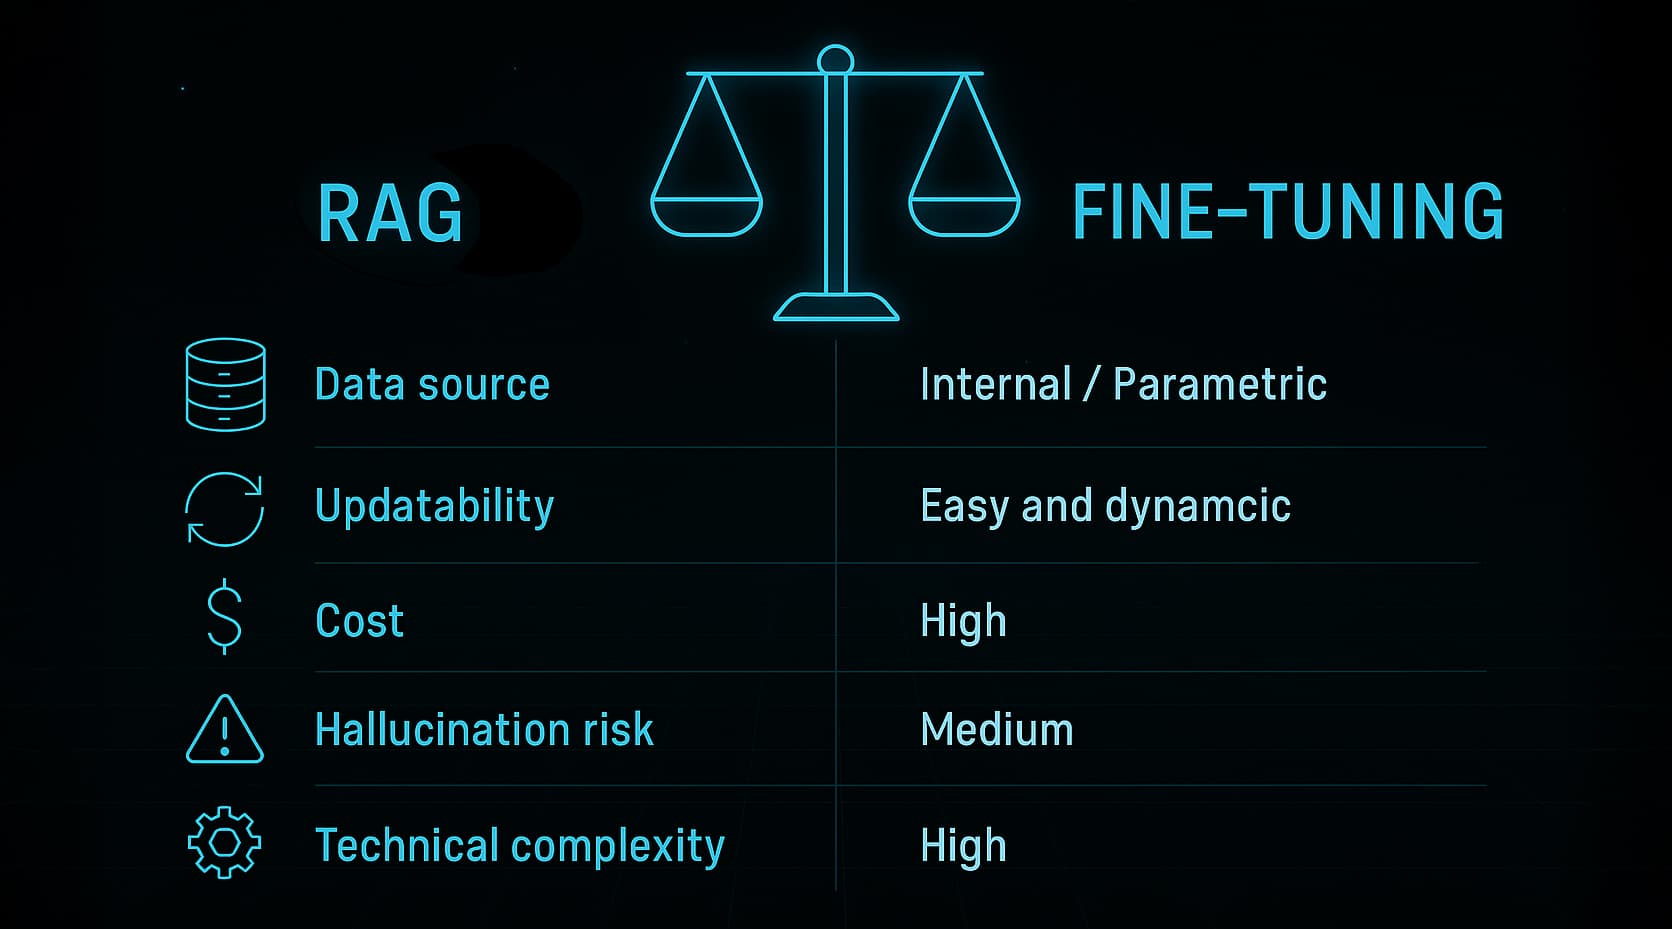
LLM yeteneklerini geliştirmek isteyenlerin en sık karşılaştığı soru şudur: RAG mi kurmalı, yoksa modeli fine-tuning ile mi eğitmeli? Doğru seçim, çözmek istediğiniz sorunun bilgi mi yoksa davranış sorunu mu olduğuna bağlıdır.
LLM Fine-Tuning Nedir? Amaçları ve Süreci
LLM fine-tuning, önceden eğitilmiş bir modelin daha küçük ve alanına özgü bir veri setiyle tekrar eğitilmesidir. Temel hedefler:
- Modelin yazım tarzını, ses tonunu veya davranışını belirli bir kullanım senaryosuna ya da marka diline uyarlamak
- Özel bilgi ve becerileri modele içsel olarak öğretmek (bilginin modelin parametrelerine gömülmesi)
Bu süreç; kaliteli veri seti, uygun eğitim altyapısı, dikkatli hiperparametre ayarları ve iyi planlanmış değerlendirme aşamaları gerektirir. Hesaplama açısından yoğun ve maliyetlidir.
RAG Ne Zaman Tercih Edilmeli?
Avantajları:
- Modeli yeniden eğitmeye gerek kalmadan dinamik bilgi güncellemesi yapılabilir
- Kaynak gösterme yeteneği sayesinde şeffaflık sağlanır
- Halüsinasyon (uydurma bilgi üretme) riski önemli ölçüde azaltılır
- Geniş veya sürekli güncellenen bilgi gerektiren sistemlerde düşük maliyetli çözüm sunar
Uygulama alanları:
- Sürekli güncellenen belgeler üzerinde çalışan soru-cevap sistemleri (örn. teknik dökümanlar, yasal belgeler, akademik makaleler)
- Güncel bilgiye ihtiyaç duyan sohbet botları (örn. haber, ürün bilgisi, finansal içerik)
- Bilgi doğruluğunun kritik olduğu kurumsal çözümler (örn. denetim, mevzuat, iç kontrol sistemleri)
Fine-Tuning Ne Zaman Tercih Edilmeli?
Avantajları:
- Modelin yazım tarzı, tonu veya kişiliği özelleştirilebilir
- Yeni beceri veya özel formatlar öğretilebilir (örn. belirli bir kod stilinde programlama)
- Harici veri çağrısının istenmediği, sabit bilgi gerektiren durumlarda uygundur
Uygulama alanları:
- Marka diline uygun metin üretimi (örn. pazarlama, reklam)
- Tıbbi raporlar gibi uzmanlık gerektiren içeriklerin belirli formatta özetlenmesi
- Harici veri kaynağına erişim olmadan, düşük gecikmeli yanıt üretimi gereken senaryolar
RAG ve Fine-Tuning Karşılaştırması
- Kriter: Bilgi KaynağıRAG: Harici (sorgu anında çekilir)Fine-Tuning: Dahili / Parametrik (model içine gömülür)
- Kriter: GüncellenebilirlikRAG: Kolay ve anlık (veri kaynağını değiştirerek)Fine-Tuning: Zor ve maliyetli (yeniden eğitim gerekir)
- Kriter: MaliyetRAG: Düşük işletme maliyeti, ancak altyapı kurulurFine-Tuning: Büyük modellerde pahalı, sık güncellemelerde maliyet artar
- Kriter: Halüsinasyon RiskiRAG: Düşük (veri destekli yanıt)Fine-Tuning: Vardır (veri dışına çıktığında)
- Kriter: Teknik KarmaşıklıkRAG: Altyapı, embedding ve retrieval bilgisi gerekirFine-Tuning: Eğitim süreci ve veri hazırlığı gerekir
- Kriter: Kaynak göstermeRAG: Mümkün (getirilen belge bellidir)Fine-Tuning: Mümkün değil (bilgi parametrelerdedir)
| Kriter | RAG | Fine-Tuning |
|---|---|---|
| Bilgi Kaynağı | Harici (sorgu anında çekilir) | Dahili / Parametrik (model içine gömülür) |
| Güncellenebilirlik | Kolay ve anlık (veri kaynağını değiştirerek) | Zor ve maliyetli (yeniden eğitim gerekir) |
| Maliyet | Düşük işletme maliyeti, ancak altyapı kurulur | Büyük modellerde pahalı, sık güncellemelerde maliyet artar |
| Halüsinasyon Riski | Düşük (veri destekli yanıt) | Vardır (veri dışına çıktığında) |
| Teknik Karmaşıklık | Altyapı, embedding ve retrieval bilgisi gerekir | Eğitim süreci ve veri hazırlığı gerekir |
| Kaynak gösterme | Mümkün (getirilen belge bellidir) | Mümkün değil (bilgi parametrelerdedir) |
Pratikte iki yöntem çoğu zaman birlikte kullanılır: fine-tuning modelin tonunu ve formatını belirler, RAG ise güncel ve doğrulanabilir bilgiyi sağlar.
RAG mı, Uzun Bağlam Penceresi mi?
Bugünkü modeller yüz binlerce token’lık bağlam penceresi sunuyor; bu yüzden “tüm dokümanları isteme koysam RAG’e gerek kalır mı?” sorusu sık soruluyor. Küçük ve sabit bir belge seti için bu işe yarayabilir. Ancak her soruda tüm metni göndermek maliyeti ve gecikmeyi token sayısıyla birlikte artırır, modeller uzun bağlamın ortasındaki bilgiyi gözden kaçırabilir ve bilgi tabanı büyüdükçe pencere yine yetmez.
Genel kural: binlerce belgeden ve sık değişen içerikten oluşan bir bilgi tabanında RAG; birkaç uzun belgenin bütünüyle okunması gereken işlerde uzun bağlam daha uygundur. İkisi birlikte de kullanılabilir: RAG ilgili bölümleri seçer, geniş pencere bunları bütün hâlinde okur.
RAG Nasıl Kurulur ve Kullanılır?
Teoriden pratiğe geçmek isteyenler için temel bir RAG sistemi aşağıdaki adımlarla kurulur.
Örnek RAG İş Akışı: 6 Adım
- Adım 1Bilgi Tabanını Hazırla
PDF, TXT gibi belgeleri topla, temizle ve yapılandır. Belge yapısı ve varsa meta veriler dikkate alınmalıdır.
- Adım 2Embedding Modeli Seç ve Uygula
İçeriğe ve dile uygun bir embedding modeli seç (Sentence-BERT, OpenAI, Cohere vb.). Belgeleri anlamlı parçalara böl, her parçayı vektöre dönüştür.
- Adım 3Vektör Veritabanı Kur ve Belgeleri İndeksle
FAISS, Pinecone, Weaviate veya ChromaDB gibi bir sistem seç. Embedding’leri yükle, indeks oluştur.
- Adım 4Veri Getirme Fonksiyonu Geliştir
Sorguyu embedding’e çevir. Vektör veritabanından benzer parçaları getir (top-k ayarına dikkat).
- Adım 5LLM Entegrasyonunu Yap
Getirilen parçaları, kullanıcının sorusunu ve talimatları tek bir istemde birleştir. Modelden yalnızca bu bağlama dayanmasını ve kaynak göstermesini iste.
- Adım 6Ölç ve İyileştir
Gerçek sorulardan bir test seti oluştur. Getirme isabetini ve yanıtın kaynağa sadakatini ölç; chunking, top-k ve reranking ayarlarını buna göre değiştir.
RAG İçin “En İyi” LLM Nasıl Seçilir?
“RAG için hangi LLM kullanılmalı?” sorusunun tek bir yanıtı yok; doğru model projeye göre değişir. Değerlendirilmesi gereken başlıca faktörler:
İyi Bir RAG Tutorial’ında Neler Olmalı?
Kendi RAG sisteminizi kurarken takip edeceğiniz bir eğitim kılavuzu şu adımları kapsamalıdır:
- Ortam kurulumu: LangChain, LlamaIndex gibi bir çerçeve ve embedding kütüphanesi kurulur, API anahtarları tanımlanır.
- Belge yükleme ve parçalama: TXT, PDF, HTML ve Markdown dosyaları okunur; chunk boyutu ve overlap stratejisi açıklanır.
- Embedding ve indeksleme: Parçalar vektöre dönüştürülür ve bir vektör veritabanına yazılır.
- Getirme fonksiyonu: Sorgu embedding’e çevrilir; top-k ve hibrit arama ayarları örneklerle gösterilir.
- İstem tasarımı: Bağlamın nasıl sunulacağı ve modelin kaynak göstermesi için talimatlar yazılır.
- Değerlendirme: Yanıtlar alaka, doğruluk ve kaynağa sadakat açısından ölçülür; RAGAS gibi çerçeveler tanıtılır.
RAG Uygulamalarında Zorluklar ve Dikkat Edilecekler
RAG önemli avantajlar sunsa da, uygulamaya geçmeden önce sahada sık karşılaşılan şu engelleri bilmek gerekir:
“Çöp girerse çöp çıkar” prensibi RAG için fazlasıyla geçerlidir.
- Getirilen bilginin kalitesi: Getirme adımı alakasız veya düşük kaliteli parça dönerse, model ne kadar güçlü olursa olsun yanıt zayıflar. Sorgu genişletme, hibrit arama ve yeniden sıralama bu yüzden kritiktir.
- Chunking stratejisi: Parça boyutu, çakışma oranı ve belge yapısı getirme kalitesini doğrudan etkiler. En iyi strateji veriye göre denenerek bulunur.
- Bağlam sınırları: Geniş bağlam pencereleri de sınırsız değildir. Getirilen metin çok uzunsa özetleme, seçme veya sıkıştırma gerekir.
- Gecikme: Getirme adımı her çağrıya ek süre ekler. Hızlı embedding modelleri, iyi indeksleme ve önbellekleme ile azaltılır.
- Maliyet: Embedding üretimi, vektör veritabanı barındırma ve LLM çağrıları ayrı maliyet kalemleridir; mimari planlanırken birlikte modellenmelidir.
- Değerlendirme: Bir RAG sistemini ölçmek, akıcılıktan fazlasını gerektirir. Aşağıdaki metrikler bu iş için standart hâle geldi.
RAG Sistemi Nasıl Değerlendirilir?
- Metrik: Faithfulness (sadakat)Ne ölçer?: Yanıttaki iddiaların getirilen bağlamla desteklenip desteklenmediği
- Metrik: Answer relevancyNe ölçer?: Yanıtın soruyla ne kadar ilgili olduğu
- Metrik: Context precisionNe ölçer?: Getirilen parçaların ne kadarının gerçekten işe yaradığı
- Metrik: Context recallNe ölçer?: Doğru yanıt için gereken bilginin getirilip getirilmediği
| Metrik | Ne ölçer? |
|---|---|
| Faithfulness (sadakat) | Yanıttaki iddiaların getirilen bağlamla desteklenip desteklenmediği |
| Answer relevancy | Yanıtın soruyla ne kadar ilgili olduğu |
| Context precision | Getirilen parçaların ne kadarının gerçekten işe yaradığı |
| Context recall | Doğru yanıt için gereken bilginin getirilip getirilmediği |
RAG ve LLM’lerin Geleceği: Öne Çıkan Eğilimler
RAG durağan bir kavram değil; araştırma laboratuvarları ve ürün ekipleri yöntemi sürekli geliştiriyor. Öne çıkan yönelimler şunlar:
- Hibrit getirme: Anlamsal (vektör) ve kelime tabanlı aramanın birleştirilmesi; hem anlam benzerliğini hem tam eşleşmeleri yakalar.
- Kendini düzelten RAG: Model getirilen belgeleri değerlendirir, yetersiz bulursa sorguyu yeniden yazıp tekrar arar.
- Konuşmaya duyarlı RAG: Çok adımlı diyaloglarda bağlamı koruyarak takip sorularını doğru anlayan sistemler.
- Çok aşamalı getirme (multi-hop): Farklı belgelerdeki bilgileri birbirine bağlayarak karmaşık soruları yanıtlayan akışlar.
- Ajanlar ve MCP: RAG, LLM ajanlarının araçlarından biri hâline geliyor. Model Context Protocol (MCP) gibi standartlar, modellerin veri kaynaklarına ve araçlara tek bir arayüzle bağlanmasını kolaylaştırıyor.
RAG’in Kurumsal Yapay Zekâ Uygulamalarındaki Rolü
RAG, Generative AI çözümlerinin güvenilir, uygulanabilir ve ölçeklenebilir hâle gelmesinde giderek daha kritik bir rol oynamaktadır. LLM’leri gerçek, güncel ve alan bazlı bilgiyle destekleme yeteneği sayesinde, ROI (yatırım geri dönüşü), doğruluk ve risk yönetiminin ön planda olduğu kurumsal kullanımlarda vazgeçilmez hâle gelmektedir.
Gelecekte RAG’in şu alanlarda daha fazla yaygınlaşması beklenmektedir:
- Genel amaçlı LLM’lerin alan bazlı bilgiyle özelleştirilmesi: Finans, hukuk, sağlık, mühendislik gibi alanlarda yeniden eğitim gerektirmeden yüksek doğruluklu çözümler sunulabilir.
- Yeni nesil kurumsal arama ve bilgi keşif sistemleri: Belge listesi yerine doğal dilde yanıtlar sunan akıllı arama platformlarının temelinde RAG yer alacaktır.
- Güvenilir yapay zeka asistanları ve yardımcı uygulamalar: Bağlama duyarlı, doğru bilgi getirme yeteneği olan LLM tabanlı yardımcılar yaygınlaşacaktır.
- Uyumluluk ve denetlenebilirlik gerektiren sektörlerde kullanım: Yapay zeka tarafından üretilen içeriklerin kaynakları izlenebilir hâle getirilerek yasal gereklilikler karşılanabilecektir.
Sonuç: RAG ile Güvenilir Yapay Zekâ
RAG, LLM’lerin harici, güncel ve alana özgü bilgiye erişmesini sağlayarak onları gerçek iş senaryolarında kullanılabilir hâle getiren mimaridir. Yanıtlar daha doğru, güncel ve kaynağı gösterilebilir olur; bilgi güncellemek için modeli yeniden eğitmek gerekmez.
Başarılı bir RAG sistemi için model seçimi kadar bilgi tabanının kalitesi, chunking stratejisi, getirme ayarları ve düzenli ölçüm de önemlidir. Küçük bir pilotla başlayıp gerçek sorularla ölçerek büyütmek, en güvenli yoldur.
RAG Hakkında Sıkça Sorulan Sorular
RAG nedir?
RAG (Retrieval-Augmented Generation), bir büyük dil modelinin yanıt üretmeden önce ilgili bilgiyi harici bir kaynaktan getirmesi ve yanıtını bu bilgiye dayandırmasıdır. Böylece yanıtlar daha güncel, doğru ve kaynağı gösterilebilir olur.
RAG neyin kısaltması?
RAG, İngilizce “Retrieval-Augmented Generation” ifadesinin kısaltmasıdır. Türkçede “getirmeyle zenginleştirilmiş üretim” ya da “erişimle artırılmış üretim” olarak çevrilir.
LLM ile RAG arasındaki fark nedir?
LLM, metin üreten dil modelinin kendisidir. RAG ise bu modelin etrafına kurulan bir mimaridir: modele her soruda ilgili belgeleri getirip verir. LLM tek başına yalnızca eğitim verisini bilir; RAG ile güncel ve kuruma özel bilgiye erişir.
ChatGPT bir RAG LLM mi?
ChatGPT’nin arkasındaki model tek başına bir LLM’dir. Web araması veya yüklenen dosyalarla yanıt verirken önce ilgili içeriği getirdiği için bu senaryolarda RAG akışı kullanır.
RAG ile fine-tuning arasındaki fark nedir?
Fine-tuning, modelin parametrelerini bir veri setiyle yeniden eğitir ve daha çok ton, format ve beceri kazandırmak için kullanılır. RAG modeli değiştirmez; bilgiyi sorgu anında harici kaynaktan getirir. Değişen ve doğrulanması gereken bilgi için RAG daha uygundur.
RAG için hangi LLM kullanılmalı?
Tek bir doğru model yok. Bağlam penceresi, talimat takibi ve bağlama sadakat, Türkçe performansı, maliyet, gecikme ve veri gizliliği gereksinimlerine göre seçilmeli; aday modeller kendi sorularınızla test edilmelidir.
RAG için vektör veritabanı şart mı?
Şart değil ama yaygın. Küçük projelerde mevcut PostgreSQL’e pgvector eklemek yeterli olabilir; bazı sistemler anahtar kelime aramasıyla veya hibrit aramayla çalışır. Önemli olan, soruyla ilgili parçaları doğru getirebilmektir.
RAG sistemleri nasıl değerlendirilir?
Getirme ve üretim ayrı ölçülür: getirilen parçaların isabeti (context precision, context recall) ve yanıtın bu parçalara sadakati (faithfulness) ile soruya uygunluğu (answer relevancy). RAGAS gibi çerçeveler bu ölçümleri otomatikleştirir.
RAG hangi alanlarda kullanılır?
Müşteri destek botları, kurum içi bilgi asistanları, dokümantasyon araması, hukuk ve mevzuat araştırması, finans ve sağlıkta rapor analizi ile yapay zekâ destekli arama motorları en yaygın kullanım alanlarıdır.
- Yapay Zekâ
- RAG
- LLM