Modelele lingvistice mari (LLM) au demonstrat un potențial remarcabil, dar se lovesc adesea de aceleași probleme: generează informații inexacte (halucinații), se bazează pe cunoștințe depășite și nu au expertiză într-un domeniu anume. Aici intervine generarea augmentată prin regăsire (Retrieval-Augmented Generation, RAG), o abordare inovatoare care schimbă radical ce pot face LLM-urile. Acest ghid, construit pe cercetarea actuală și pe implementări practice din domeniul AI, definește RAG LLM, explică exact ce este RAG în LLM, detaliază cum funcționează, îi evidențiază beneficiile, îi analizează arhitectura, îl compară cu fine-tuning-ul și oferă repere practice pentru implementare. La final vei înțelege cum generarea augmentată prin regăsire poate îmbunătăți semnificativ performanța AI, ducând la sisteme mai fiabile și mai demne de încredere.
Ce este generarea augmentată prin regăsire (RAG) în LLM?
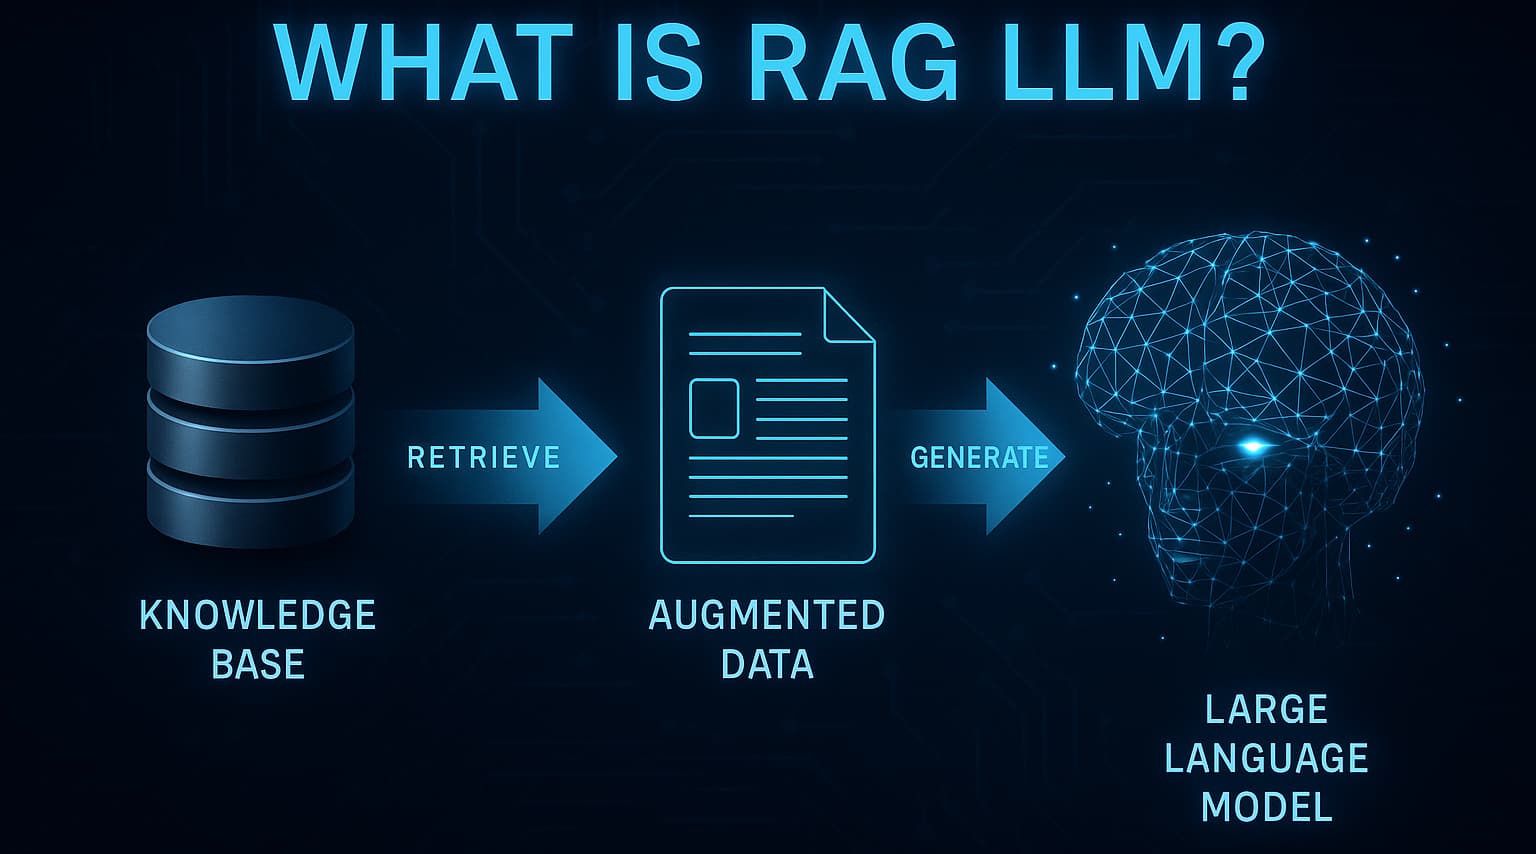
Scopul principal al RAG este să îmbunătățească semnificativ calitatea și fiabilitatea răspunsurilor generate de LLM. Răspunde direct intenției informaționale din spatele căutărilor precum „ce este rag în llm” sau „rag llm semnificație”, clarificând cum această tehnologie îmbunătățește sistemele rag în llm standard, astfel încât rezultatele lor să fie mai bine ancorate în fapte.
Definiția RAG: dincolo de capacitățile unui LLM standard
Generarea augmentată prin regăsire (RAG) este o tehnică ce îmbunătățește modelele lingvistice mari (LLM) prin integrarea unor surse de cunoștințe externe și actualizate înainte ca LLM-ul să genereze răspunsul. Combină inteligent punctele forte ale sistemelor de regăsire a informațiilor (găsirea datelor relevante) cu puterea generativă sofisticată a LLM-urilor. Semnificația RAG LLM se rezumă la această sinergie: LLM-urile nu mai sunt limitate la informațiile pe care au fost antrenate. Pe scurt, pentru cine caută o privire de ansamblu rapidă, RAG este un sistem care îmbunătățește răspunsurile LLM furnizându-le informații relevante, regăsite din surse externe ca răspuns la o interogare, astfel încât răspunsurile să fie actuale și potrivite contextului. Abordarea este larg recunoscută în comunitatea de cercetare AI drept una dintre metodele-cheie pentru un AI mai factual.
Problemele de bază ale LLM-urilor pe care le rezolvă RAG
RAG abordează direct mai multe limitări inerente ale LLM-urilor standard, făcându-le mai potrivite pentru aplicații reale, critice:
- Halucinațiile: Ancorând răspunsurile în date factuale, verificabile, regăsite din surse externe, RAG reduce semnificativ riscul ca LLM-ul să inventeze informații. Este un pas esențial spre un AI pe care te poți baza.
- Cunoștințele depășite: LLM-urile sunt antrenate pe seturi de date statice, așa că data-limită a cunoștințelor lor (knowledge cutoff) le împiedică să acceseze evenimente sau informații recente. RAG depășește această limită aducând dinamic cele mai noi date, ceea ce asigură actualitatea răspunsurilor.
- Golurile de cunoștințe de domeniu: LLM-urile standard pot să nu înțeleagă în profunzime conținutul specializat sau proprietar al unei companii. RAG le permite să acceseze și să folosească aceste informații specifice, ceea ce le face mult mai utile pentru aplicații de nișă și pentru managementul cunoștințelor interne.
- Lipsa de transparență: Deși e un beneficiu implicit, RAG poate face raționamentul LLM-ului mai ușor de urmărit. Știind ce documente regăsite au stat la baza răspunsului, utilizatorii pot avea mai multă încredere în rezultat și pot verifica informațiile, un aspect crucial pentru adoptarea în companii și pentru câștigarea încrederii utilizatorilor.
Cum funcționează RAG: mecanismul, pe scurt
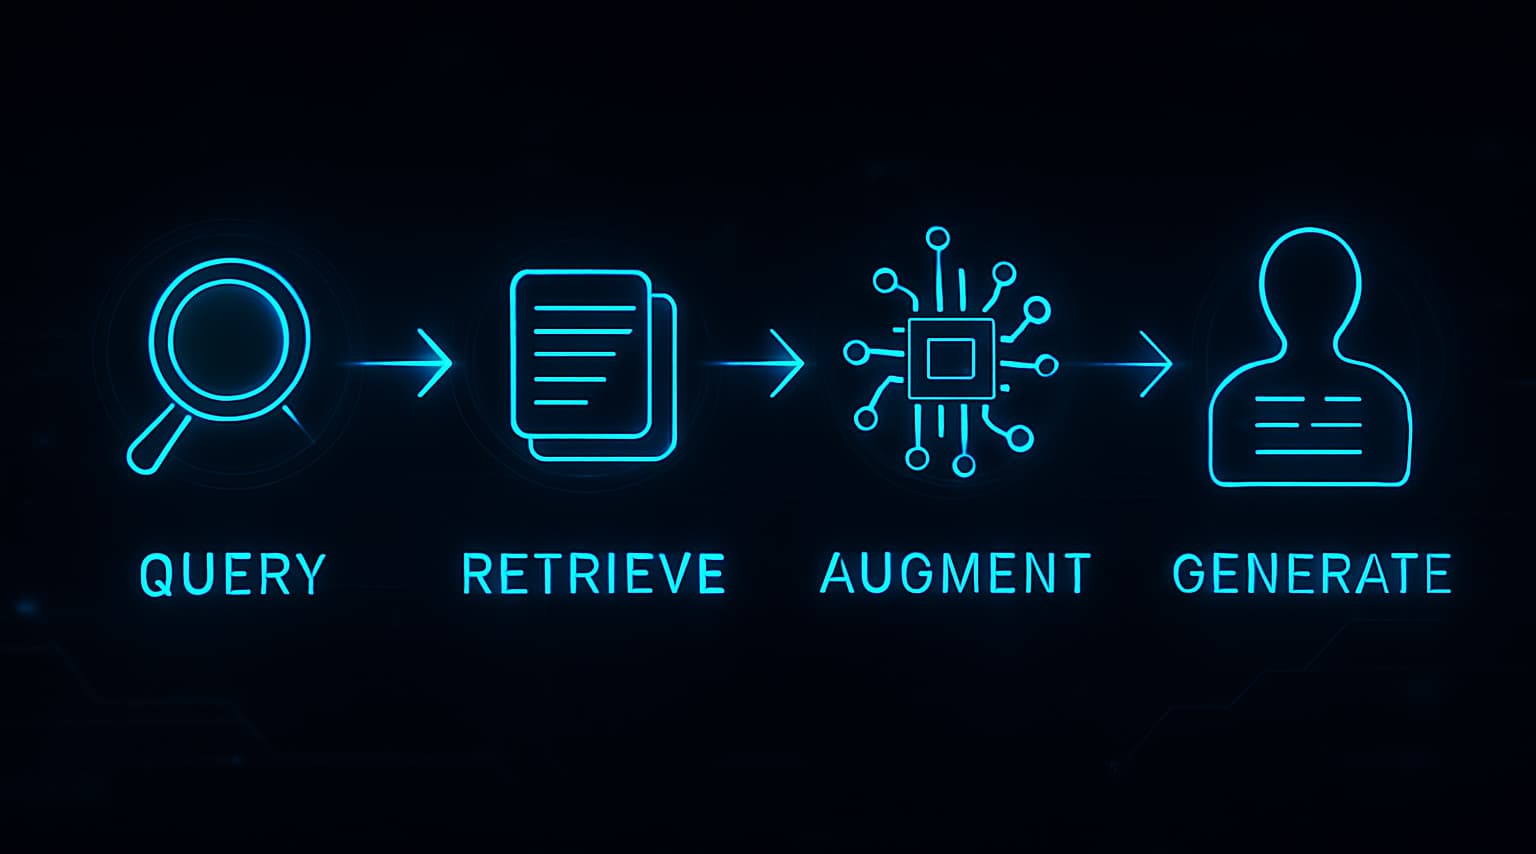
Privit tehnic, de la nivel înalt, procesul RAG se împarte în câțiva pași-cheie:
- Se primește interogarea utilizatorului: Procesul începe când utilizatorul trimite o întrebare sau un prompt sistemului.
- Regăsirea informațiilor: Un sistem de regăsire a informațiilor caută în baze de cunoștințe externe (baze de date, depozite de documente ale companiei, date publice de pe web) documente sau fragmente de date relevante pentru interogarea utilizatorului. De regulă, asta presupune transformarea documentelor în documente vectorizate (embedding-uri) și efectuarea unor căutări de similaritate. Vectorizarea este critică, pentru că îi permite sistemului să înțeleagă sensul semantic al textului, nu doar să potrivească cuvinte-cheie.
- Augmentarea contextului: Fragmentele de date regăsite sunt apoi combinate cu interogarea inițială a utilizatorului pentru a forma un prompt augmentat. Astfel, LLM-ul primește un context bogat, direct relevant pentru interogare.
- LLM-ul generează răspunsul: LLM-ul procesează promptul augmentat și generează un răspuns ancorat acum în informațiile externe furnizate, în loc să se bazeze exclusiv pe cunoștințele sale parametrice interne, posibil depășite.
Beneficii-cheie: de ce RAG transformă performanța LLM
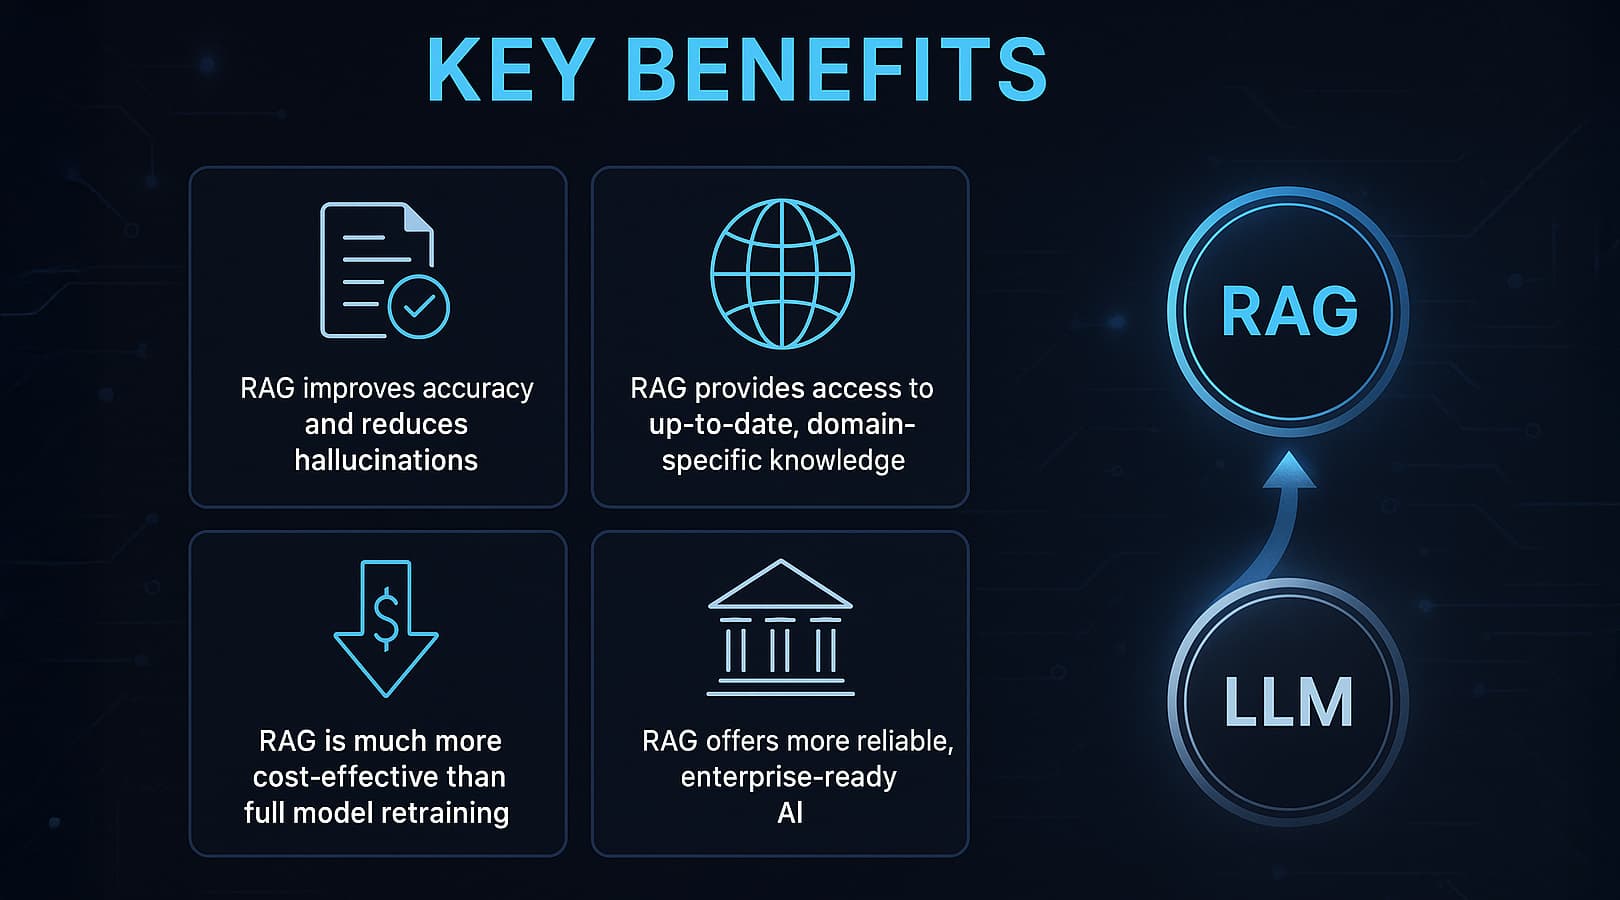
Adoptarea RAG crește rapid datorită avantajelor semnificative și demonstrabile pe care le aduce capacităților și fiabilității LLM-urilor.
Acuratețe mult mai mare și mai puține halucinații
Furnizând LLM-urilor „date de ancorare” factuale, verificabile, regăsite în timp real, RAG face ca răspunsurile să se bazeze pe informații concrete, un beneficiu evidențiat atât în cercetarea AI, cât și în aplicațiile reale. Astfel scade mult dependența LLM-ului doar de memoria sa parametrică, care poate duce uneori la confabulații sau „halucinații”.
Acces la cunoștințe actuale și specifice domeniului
RAG le permite LLM-urilor să acceseze informații mult dincolo de data ultimei antrenări. Este extrem de valoros pentru aplicațiile care au nevoie de date actuale, precum rezumarea știrilor sau analiza financiară. În plus, e esențial pentru soluțiile enterprise care trebuie să valorifice cunoștințele proprietare ale companiei, documentația internă sau informații de industrie care se schimbă rapid.
Mai ieftin și mai eficient decât reantrenarea LLM-ului
În mod tradițional, actualizarea cunoștințelor unui LLM cere o reantrenare amplă și costisitoare. Cu RAG, cunoștințele se actualizează simplu, adăugând sau modificând date în sursa externă. Este semnificativ mai ieftin și mai rapid și permite integrarea frecventă a informațiilor noi fără a afecta LLM-ul în sine. Acest avantaj economic este un motor important al adoptării RAG, mai ales pentru organizațiile care trebuie să își țină AI-ul la curent cu date care se schimbă des.
AI enterprise mai fiabil și mai demn de încredere
În aplicațiile critice pentru business, acuratețea și actualitatea informațiilor generate de AI sunt esențiale. RAG crește încrederea în rezultatele AI, făcându-le mai factuale și mai ușor de verificat. La rândul său, asta facilitează adoptarea pe scară largă a AI-ului generativ (GenAI) în mediile enterprise, unde încrederea, responsabilitatea și fiabilitatea nu sunt negociabile.
Arhitectura RAG și componentele ei
O înțelegere mai profundă a structurii tehnice, numită adesea arhitectură rag llm sau, în forma ei tipică, pipeline rag llm, este extrem de utilă practicienilor care vor să construiască, să evalueze sau să integreze eficient sisteme RAG.
Pipeline-ul RAG tipic, explicat
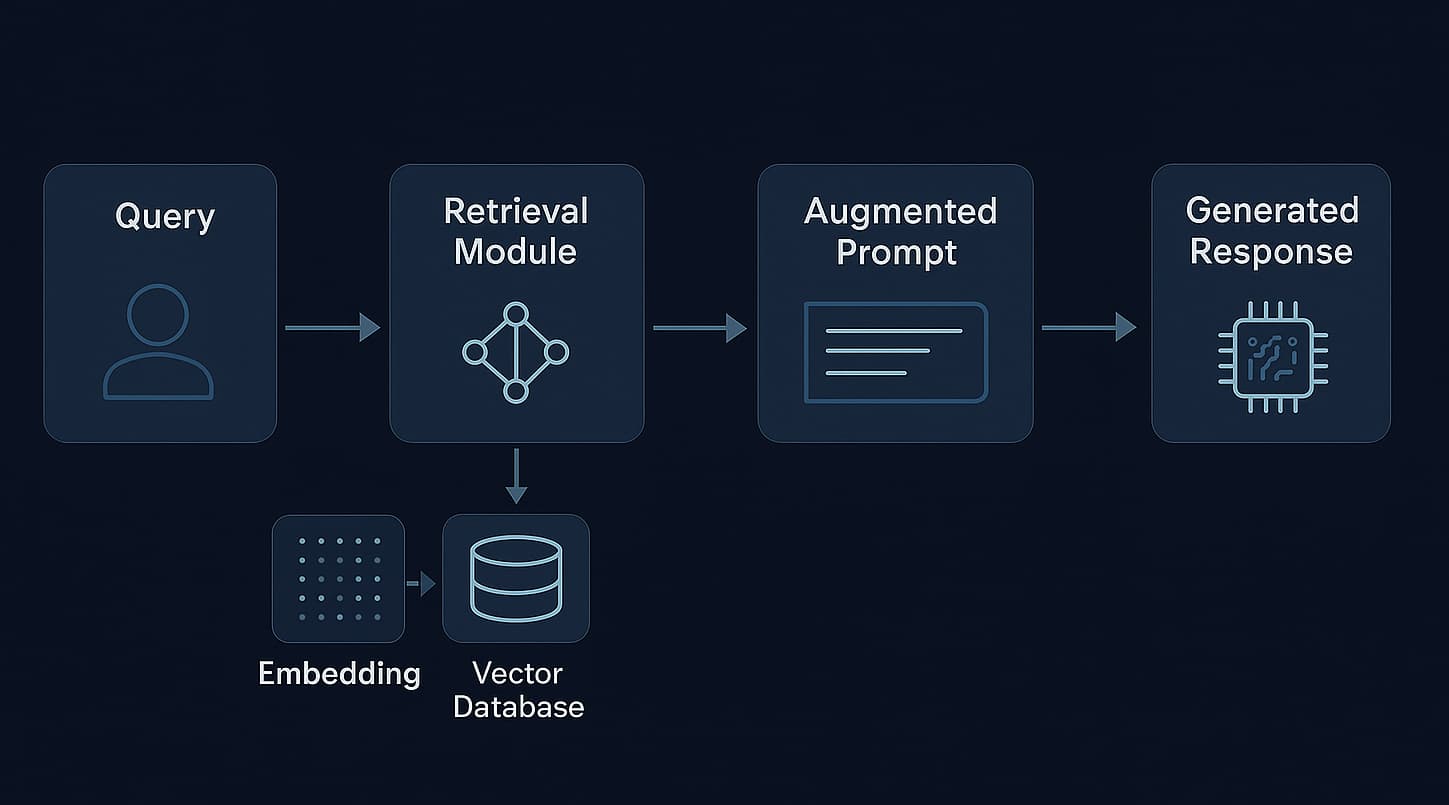
Un pipeline rag llm obișnuit sau o arhitectură llm rag constă din mai multe etape interconectate, fiecare cerând un design și o optimizare atente:
- Ingestia și pregătirea datelor: Această fază inițială, considerată adesea fundamentul unei implementări RAG reușite, presupune colectarea cunoștințelor din diverse surse (documente, baze de date, API-uri). Datele sunt apoi procesate, de regulă prin „fragmentarea documentelor” (chunking – împărțirea documentelor mari în bucăți mai mici, ușor de gestionat) și „generarea de embedding-uri” (transformarea fragmentelor de text în reprezentări vectoriale numerice cu ajutorul unui model de embedding). Embedding-urile sunt apoi stocate și indexate, de obicei într-o bază de date vectorială.
- Modulul de regăsire: Când sosește o interogare, aceasta poate fi și ea transformată într-un embedding. Modulul de regăsire efectuează apoi o căutare de similaritate (de exemplu, similaritatea cosinus) în baza de date vectorială, pentru a găsi fragmentele de documente cele mai relevante pentru interogare. Fragmentele relevante sunt apoi ordonate.
- Modulul de augmentare/contextualizare: Fragmentele regăsite cel mai bine clasate sunt formatate și combinate cu interogarea inițială a utilizatorului pentru a crea un „prompt augmentat”. Pasul este proiectat cu grijă, astfel încât LLM-ul să primească contextul într-un format optim, ușor de procesat, care favorizează un raționament mai bun.
- Modulul de generare: În final, promptul augmentat este transmis modelului lingvistic mare (LLM). LLM-ul folosește contextul furnizat de documentele regăsite pentru a genera un răspuns coerent, informat și relevant la interogarea inițială.
Eficiența modulului de regăsire este esențială: calitatea fragmentelor regăsite influențează direct acuratețea și relevanța răspunsului final.
Componente-cheie: de ce ai nevoie pentru un sistem RAG
Construirea unui sistem rag llm funcțional și robust necesită mai multe componente-cheie, fiecare cu propriile considerente:
- Bazele de cunoștințe: Sunt sursele de date externe din care se alimentează RAG. Pot include documente interne ale companiei (PDF-uri, fișiere Word, wiki-uri), baze de date, site-uri, API-uri sau orice colecție de informații în format text. Calitatea și organizarea acestor surse sunt critice.
- Modelele de embedding: Aceste modele, bazate adesea pe arhitecturi transformer precum BERT, Sentence-BERT sau Ada de la OpenAI, sunt esențiale pentru transformarea textului (atât din baza de cunoștințe, cât și din interogările utilizatorilor) în vectori numerici (embedding-uri). Așa devine posibilă căutarea semantică, care surprinde sensul și contextul textului, nu doar potrivirea de cuvinte-cheie.
- Bazele de date vectoriale: Baze de date specializate, concepute pentru stocarea, gestionarea și interogarea eficientă a unor volume mari de embedding-uri vectoriale. Exemple: Pinecone, Weaviate, FAISS și Milvus. Alegerea depinde de obicei de factori precum volumul de date, cerințele de latență ale interogărilor, modul de implementare (cloud sau on-premise) și infrastructura cloud existentă, adică de considerente practice de implementare.
- Modelele/algoritmii de regăsire: Sunt sistemele sau algoritmii care caută eficient în baza de date vectorială și aduc cele mai relevante fragmente de informație pe baza interogării utilizatorului. Pot merge de la o simplă căutare de similaritate până la algoritmi de ordonare mai complecși, uneori cu modele de ranking bazate pe machine learning.
- Modelele lingvistice mari (LLM): Componenta generativă care preia interogarea utilizatorului și informațiile contextuale regăsite pentru a sintetiza răspunsul final. Alegerea LLM-ului poate influența calitatea, stilul, latența și costul sistemului RAG.
Paradigme RAG: naiv, avansat și modular
Domeniul RAG evoluează, iar cercetarea AI recentă, inclusiv studii de sinteză ample pe acest subiect, identifică diverse tipare arhitecturale dincolo de un simplu model rag llm:
- RAG naiv: Este forma cea mai simplă, care urmează o abordare directă de tip „regăsește, apoi citește”. Componenta de regăsire aduce documentele relevante, iar LLM-ul le folosește pentru a genera un răspuns. Deși e ușor de implementat, poate suferi de o regăsire suboptimă (de exemplu, fragmente irelevante) sau de o generare suboptimă (de exemplu, contextul nu este folosit pe deplin).
- RAG avansat: Include tehnici menite să îmbunătățească anumite etape ale pipeline-ului RAG naiv. De exemplu, preprocesarea interogărilor (extinderea sau transformarea interogării) ori postprocesarea documentelor regăsite (reordonare, rezumare, filtrare) pentru o relevanță mai bună, sau regăsirea iterativă, în care LLM-ul poate cere mai multe informații dacă contextul inițial nu este suficient.
- RAG modular: Această paradigmă pune accent pe o arhitectură flexibilă, în care diferitele componente (componenta de regăsire, LLM-ul generator sau chiar modulele de memorie) pot fi înlocuite, actualizate sau optimizate ușor și independent. Oferă o adaptabilitate mai mare și permite ajustarea sistemului RAG la nevoi specifice și la tehnologii în evoluție, reflectând o abordare inginerească matură.
RAG vs. fine-tuning LLM: ce abordare ți se potrivește?
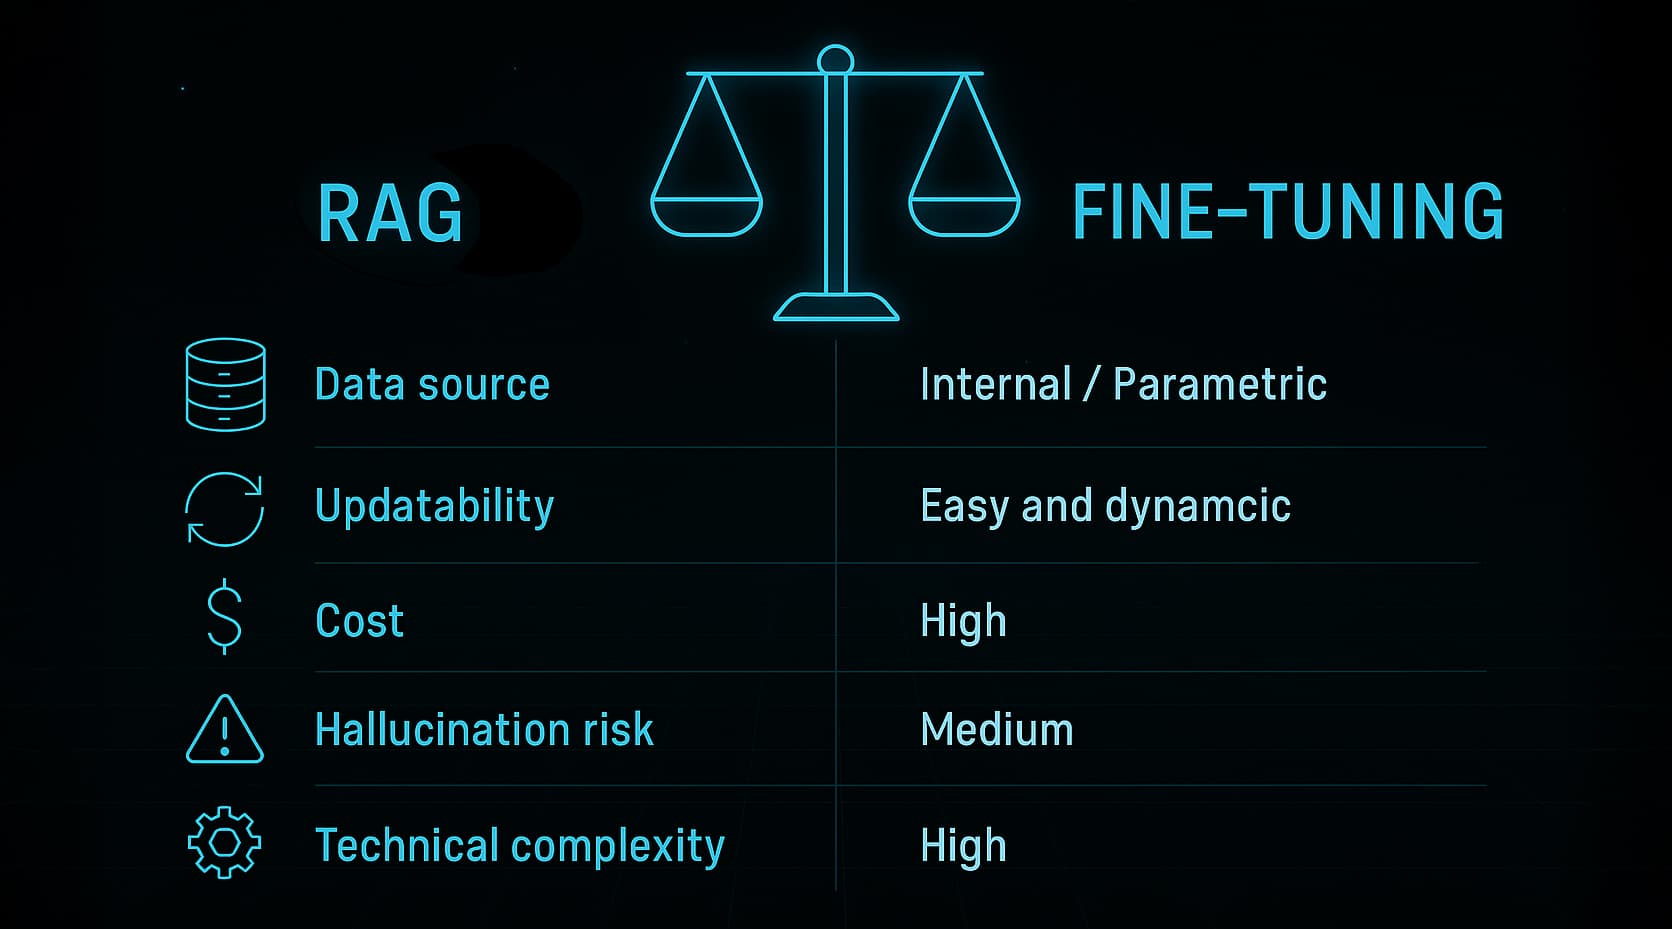
O întrebare frecventă pentru cei care vor să extindă capacitățile unui LLM, și un punct de decizie critic în proiectarea unor soluții AI eficiente, este dacă să folosească RAG sau fine-tuning. Înțelegerea diferențelor, reflectată în căutări precum „llm fine tuning vs rag” sau „rag vs llm”, este esențială pentru a lua decizia de arhitectură potrivită, în funcție de obiectivele proiectului și de resursele disponibile.
Fine-tuning-ul unui LLM: obiective și proces
Fine-tuning-ul unui LLM înseamnă să iei un model lingvistic mare preantrenat și să-l antrenezi suplimentar pe un set de date mai mic, specific unui domeniu. Obiectivele principale sunt de obicei:
- Adaptarea comportamentului, stilului de scriere sau tonului LLM-ului pentru a se potrivi mai bine cu vocea unui brand sau cu cerințele unei aplicații.
- Încorporarea unor cunoștințe specifice sau învățarea unor abilități noi în mod parametric, adică acele cunoștințe devin parte din ponderile interne ale modelului.
Fine-tuning-ul presupune un set de date de calitate, un mediu de antrenare și rularea procesului, care poate cere multă putere de calcul și o ajustare și evaluare atentă a hiperparametrilor.
RAG: puncte forte și când îl folosești
RAG excelează datorită câtorva puncte forte esențiale, care îl fac foarte eficient în anumite scenarii:
- Puncte forte: Actualizarea dinamică a cunoștințelor (actualizezi pur și simplu sursa de date externă, fără să reantrenezi modelul), posibilitatea de a indica sursele (le arăți utilizatorilor de unde provine informația, unul dintre pilonii încrederii în sistemele AI), reducerea semnificativă a halucinațiilor la întrebările factuale și un cost avantajos pentru integrarea unor cunoștințe externe extinse sau care se schimbă rapid.
- Cazuri de utilizare: Ideal pentru sisteme de întrebări și răspunsuri peste colecții dinamice de documente (de exemplu, manuale tehnice, documente juridice, lucrări de cercetare), chatboți care au nevoie de informații actuale (de exemplu, știri, actualizări de produs) și orice sistem în care acuratețea factuală, ancorată în surse specifice, actuale și auditabile, este critică.
Fine-tuning: puncte forte și când îl folosești
Fine-tuning-ul are propriile avantaje și este preferabil în alte situații:
- Puncte forte: Eficient pentru adaptarea stilului, tonului sau personalității unui LLM; pentru a-l învăța abilități implicite, formate sau sarcini specializate noi (de exemplu, generarea de cod într-un stil foarte anume); și pentru a încorpora profund cunoștințe atunci când apelurile externe nu sunt fezabile sau dorite ori când cunoștințele sunt relativ statice, dar foarte specializate.
- Cazuri de utilizare: Adaptarea unui LLM la vocea unui brand pentru texte de marketing, antrenarea unui LLM pentru o sarcină de nișă, precum rezumarea rapoartelor medicale într-un anumit format, sau situațiile în care cunoștințele necesare sunt stabile și trebuie să facă parte intrinsec din comportamentul modelului, pentru răspunsuri cu latență mică, fără apeluri externe.
RAG vs. fine-tuning: diferențe, avantaje și dezavantaje
Iată principalele diferențe, ca sprijin în luarea deciziei:
- Criteriu: Integrarea cunoștințelorRAG: Externă (cunoștințele sunt regăsite din afara LLM-ului în momentul interogării).Fine-tuning: Internă/parametrică (cunoștințele sunt încorporate în ponderile LLM-ului).
- Criteriu: ActualizareRAG: Ușoară și dinamică (actualizezi sursa externă de cunoștințe; modificările se reflectă imediat).Fine-tuning: Necesită reantrenare sau un nou fine-tuning, care poate consuma multe resurse și mult timp.
- Criteriu: CostRAG: În general, cost operațional mai mic pentru actualizarea cunoștințelor. Necesită configurarea inițială a infrastructurii de regăsire. Costurile de inferență includ regăsirea și generarea.Fine-tuning: Poate fi costisitor dacă reantrenarea e frecventă, mai ales la modelele mari. Costurile de inferență acoperă de regulă doar apelul către LLM.
- Criteriu: Controlul halucinațiilorRAG: Mai bun, pentru că răspunsurile sunt ancorate în fapte regăsite. Totuși, calitatea ancorării depinde direct de relevanța și acuratețea documentelor regăsite.Fine-tuning: Poate halucina în continuare, deși mai rar pe subiectele acoperite explicit și temeinic în setul de date de fine-tuning.
- Criteriu: ComplexitateRAG: Adaugă complexitatea infrastructurii de regăsire (baze de date vectoriale, modele de embedding, logică de regăsire). De regulă cere expertiză în regăsirea informațiilor și data engineering.Fine-tuning: Cere expertiză în pregătirea datelor, procesele de antrenare și ajustarea hiperparametrilor. De regulă, este domeniul inginerilor de machine learning.
| Criteriu | RAG | Fine-tuning |
|---|---|---|
| Integrarea cunoștințelor | Externă (cunoștințele sunt regăsite din afara LLM-ului în momentul interogării). | Internă/parametrică (cunoștințele sunt încorporate în ponderile LLM-ului). |
| Actualizare | Ușoară și dinamică (actualizezi sursa externă de cunoștințe; modificările se reflectă imediat). | Necesită reantrenare sau un nou fine-tuning, care poate consuma multe resurse și mult timp. |
| Cost | În general, cost operațional mai mic pentru actualizarea cunoștințelor. Necesită configurarea inițială a infrastructurii de regăsire. Costurile de inferență includ regăsirea și generarea. | Poate fi costisitor dacă reantrenarea e frecventă, mai ales la modelele mari. Costurile de inferență acoperă de regulă doar apelul către LLM. |
| Controlul halucinațiilor | Mai bun, pentru că răspunsurile sunt ancorate în fapte regăsite. Totuși, calitatea ancorării depinde direct de relevanța și acuratețea documentelor regăsite. | Poate halucina în continuare, deși mai rar pe subiectele acoperite explicit și temeinic în setul de date de fine-tuning. |
| Complexitate | Adaugă complexitatea infrastructurii de regăsire (baze de date vectoriale, modele de embedding, logică de regăsire). De regulă cere expertiză în regăsirea informațiilor și data engineering. | Cere expertiză în pregătirea datelor, procesele de antrenare și ajustarea hiperparametrilor. De regulă, este domeniul inginerilor de machine learning. |
Sinergii: se pot folosi împreună RAG și fine-tuning-ul?
Da, RAG și fine-tuning-ul nu se exclud reciproc și pot fi foarte complementare. O abordare hibridă puternică presupune:
- Fine-tuning-ul unui LLM pe un set de date specific domeniului, pentru a-i adapta stilul, pentru a-l face să înțeleagă jargonul de specialitate sau pentru a-i îmbunătăți performanța în anumite sarcini relevante pentru domeniu (de exemplu, respectarea mai bună a instrucțiunilor privind contextul regăsit).
- Apoi, folosirea RAG cu acest LLM ajustat, pentru a-i furniza în momentul interogării cele mai noi, mai specifice sau mai dinamice informații din domeniul respectiv.
Combinația îți permite să valorifici adaptările de stil și abilitățile specializate obținute prin fine-tuning, cu acces garantat la cunoștințe factuale actuale și complete prin RAG.
Sfaturi practice: implementarea și valorificarea RAG
Dincolo de teorie, secțiunea aceasta oferă sfaturi aplicabile pentru cei care iau în calcul implementarea RAG, pornind de la practicile uzuale și de la provocările întâlnite în teren de practicienii AI.
Primii pași: un exemplu conceptual de flux RAG LLM
Pentru cine caută un „exemplu rag llm” ca să înțeleagă fluxul, iată o schiță conceptuală, bazată pe practicile tipice de dezvoltare, pentru construirea unui sistem RAG de bază:
- Pasul 1Pregătește baza de cunoștințe
Adună documentele (de exemplu, fișiere text, PDF-uri). Curăță-le și preprocesează-le după caz. Ține cont de structura documentelor și de metadate.
- Pasul 2Alege și implementează un model de embedding
Alege un model de embedding (de exemplu, Sentence-BERT, OpenAI embeddings, Cohere embeddings) potrivit pentru conținutul, limba și cerințele tale de performanță. Folosește-l pentru a transforma fragmentele de documente în embedding-uri vectoriale.
- Pasul 3Configurează un vector store și indexează documentele
Alege o bază de date vectorială (de exemplu, FAISS pentru experimente locale, Pinecone, Weaviate sau ChromaDB pentru soluții în cloud ori mai robuste). Stochează embedding-urile documentelor în această bază de date și creează un index pentru căutări eficiente.
- Pasul 4Dezvoltă o funcție de regăsire
Implementează o funcție care preia interogarea utilizatorului, o transformă într-un embedding (cu același model ca la pasul 2) și interoghează vector store-ul pentru a găsi fragmentele de documente cele mai similare (relevante). Stabilește câte fragmente (k) să fie regăsite.
- Pasul 5Integrează un API de LLM
Transmite fragmentele de documente regăsite (drept context), împreună cu interogarea inițială a utilizatorului, către un LLM (de exemplu, printr-un API precum modelele GPT de la OpenAI, Claude de la Anthropic sau un model găzduit local, precum Llama). Formulează promptul cu grijă, astfel încât LLM-ul să folosească contextul furnizat pentru a răspunde precis și concis la întrebare. Prompt engineering-ul eficient este o abilitate-cheie pentru a maximiza performanța RAG și cere adesea mai multe iterații.
Aceasta este o prezentare simplificată; un tutorial complet, așa cum caută adesea dezvoltatorii, ar intra în detaliu la fiecare pas, cu fragmente de cod, sfaturi de depanare și strategii de optimizare a performanței.
Cum alegi „cel mai bun” LLM pentru RAG
Nu există un singur „cel mai bun llm pentru rag”, pentru că alegerea optimă depinde în mare măsură de cerințele specifice ale proiectului, de buget, de nevoile de performanță și de infrastructura existentă. Totuși, iată factorii-cheie de luat în calcul:
Ce ar acoperi un „tutorial RAG LLM”
Cei care caută un „tutorial rag llm” sau „llm rag tutorial” vor îndrumare practică, pas cu pas. Un tutorial complet și de calitate, gândit pentru practicieni, ar acoperi de regulă:
- Configurarea mediului: Instalarea bibliotecilor necesare (de exemplu, LangChain, LlamaIndex, sentence-transformers, clienți pentru baze de date vectoriale precum pinecone-client sau weaviate-client) și configurarea cheilor API pentru LLM-uri și alte servicii.
- Încărcarea și fragmentarea documentelor: Cum se încarcă diverse tipuri de documente (TXT, PDF, HTML, Markdown) și cum se împart strategic în fragmente mai mici, cu sens semantic, inclusiv o discuție despre strategiile uzuale și considerentele privind dimensiunea fragmentelor și suprapunerea dintre ele.
- Generarea embedding-urilor și stocarea într-o bază de date vectorială: Parcurgerea procesului de folosire a modelului de embedding ales și de indexare a vectorilor rezultați în baza de date vectorială selectată (de exemplu, FAISS pentru uz local sau un serviciu gestionat precum Pinecone sau Chroma).
- Implementarea unei funcții de regăsire: Scrierea codului care preia o interogare, generează embedding-ul ei și regăsește fragmentele relevante din baza de date vectorială, eventual cu tehnici de ajustare a numărului de documente regăsite (top-k).
- Formularea prompturilor pentru LLM: Cum se construiesc prompturi eficiente, care îi cer clar LLM-ului să folosească contextul regăsit pentru a răspunde, să nu inventeze informații și să citeze sursele, dacă e cazul. Acesta este adesea un proces iterativ de rafinare, pe baza rezultatelor observate și a comportamentului dorit.
- Rularea interogărilor și evaluarea rezultatelor: Cum se rulează sistemul RAG cap-coadă, cu strategii practice și metrici-cheie pentru evaluarea calității răspunsurilor generate (de exemplu, relevanța, consecvența factuală, fidelitatea față de surse și folosirea contextului). Aici pot fi introduse framework-uri precum RAGAs.
Provocări și aspecte de luat în calcul la implementare
Deși RAG aduce beneficii semnificative, e important să abordezi implementarea conștient de provocările posibile, pe care practicienii le întâlnesc frecvent și pe care trebuie să le rezolve pentru soluții robuste:
Principiul „garbage in, garbage out” se aplică aici cu toată rigoarea.
- Calitatea regăsirii: Dacă pasul de regăsire aduce informații irelevante sau de slabă calitate, răspunsul LLM-ului va avea probabil de suferit, oricât de capabil ar fi LLM-ul. Optimizarea regăsirii este crucială și se face adesea prin tehnici precum extinderea interogării, reordonarea (reranking), căutarea hibridă (care combină căutarea după cuvinte-cheie cu cea semantică) sau fine-tuning-ul modelelor de embedding.
- Strategia de fragmentare: Dimensiunea, suprapunerea și conținutul fragmentelor de documente pot influența semnificativ performanța regăsirii și contextul furnizat LLM-ului. Găsirea strategiei optime cere de obicei experimentare atentă și evaluare pe setul tău de date și pe cazul tău de utilizare.
- Limitele de lungime a contextului LLM-urilor: Chiar și cu ferestre de context mari, există o limită a informațiilor care pot fi transmise. Pot fi necesare strategii de rezumare a textului regăsit, de selectare a celor mai importante fragmente sau de reordonare a lor pentru a încăpea în fereastra de context, mai ales când contextul regăsit este foarte mare.
- Latența: Pasul de regăsire adaugă o etapă de procesare în plus, care poate crește latența față de interogarea directă a unui LLM. Optimizarea vitezei de regăsire, de exemplu prin indexare eficientă, strategii de caching sau modele de embedding/baze de date vectoriale mai rapide, este importantă pentru aplicațiile în timp real.
- Costul: Există costuri asociate generării embedding-urilor (dacă folosești API-uri plătite sau resurse GPU), găzduirii/utilizării bazei de date vectoriale și apelurilor către API-urile LLM. Acestea trebuie modelate atent și incluse în designul general al sistemului și în bugetul operațional.
- Complexitatea evaluării: Măsurarea performanței unui sistem RAG poate fi complexă. Metricile trebuie să evalueze nu doar fluența textului generat, ci și acuratețea factuală, relevanța în raport cu documentele regăsite și fidelitatea (evitarea contradicțiilor cu sursele). Framework-uri precum RAGAS sau pipeline-uri de evaluare personalizate urmăresc să standardizeze și să automatizeze părți din acest proces de evaluare.
Viitorul RAG și al LLM-urilor
Generarea augmentată prin regăsire nu este un concept static, ci un domeniu în plină evoluție, în care cercetători de top, instituții academice și laboratoare din industrie împing constant limitele posibilului.
Tehnici RAG în evoluție și inovații
Cercetarea în curs, publicată adesea pe platforme precum Arxiv sau prezentată la marile conferințe de AI (de exemplu, NeurIPS, ICML, ACL), extinde constant capacitățile RAG. Vedem inovații în:
- Metode de regăsire hibride: Combinarea căutării vectoriale dense (semantice) cu căutarea tradițională după cuvinte-cheie (lexicale), pentru o regăsire mai robustă și mai nuanțată, care surprinde atât similaritatea semantică, cât și potrivirile exacte.
- Regăsire adaptivă (RAG cu autocorectare): Sisteme în care LLM-ul sau un agent intermediar poate evalua documentele regăsite inițial și poate decide dacă e nevoie de mai multe informații ori de altele, eventual interogând din nou baza de cunoștințe sau reformulând interogarea. Seamănă cu un proces de documentare mai apropiat de cel uman.
- RAG conversațional: Extinderea RAG astfel încât să păstreze contextul și să regăsească eficient informații pe parcursul mai multor replici dintr-un dialog, înțelegând întrebările ulterioare și coreferințele.
- Regăsire multi-hop: Sistemul poate parcurge mai multe documente sau puncte de date pentru a sintetiza un răspuns care cere conectarea unor informații disparate, adică un raționament mai complex.
- Integrarea cu agenți LLM și cu fluxuri de raționament mai complexe: RAG devine o componentă centrală în sisteme sofisticate de rezolvare a problemelor, în care LLM-ul decide când și cum să folosească instrumentul de regăsire.
Rolul în creștere al RAG în AI-ul enterprise și de nișă
RAG este pe cale să joace un rol tot mai important în a face AI-ul generativ mai demn de încredere, mai aplicabil și mai scalabil pentru companii. Capacitatea sa de a ancora LLM-urile în cunoștințe factuale, actuale și specifice domeniului este esențială pentru cazurile de utilizare enterprise, unde ROI-ul, acuratețea și reducerea riscurilor sunt factori decisivi. Ne așteptăm ca RAG să fie folosit tot mai mult pentru:
- Personalizarea LLM-urilor de uz general pentru domenii de cunoaștere foarte specifice (de exemplu, finanțe, juridic, sănătate, inginerie), fără reantrenări complete, costisitoare și frecvente ale modelului.
- Alimentarea platformelor de căutare enterprise și de descoperire a cunoștințelor de nouă generație, care oferă răspunsuri în limbaj natural în loc de simple liste de documente.
- Îmbunătățirea asistenților AI și a copiloților cu capacități de regăsire a informațiilor fiabile și conștiente de context, care îi fac cu adevărat utili.
- Asigurarea conformității și a auditabilității în industriile reglementate, prin surse trasabile pentru conținutul generat de AI.
Concluzie
Generarea augmentată prin regăsire (RAG) se remarcă drept o tehnologie esențială pentru a valorifica întregul potențial al modelelor lingvistice mari în scenarii practice, reale. Permițând LLM-urilor să acceseze și să folosească cunoștințe externe, actuale și specifice domeniului, RAG le face semnificativ mai precise, mai actuale, mai fiabile și, în final, mai utile.
Concluzia principală, susținută de o adoptare în creștere și de o cercetare amplă, este că sistemele RAG LLM fac legătura critică dintre cunoștințele generale, preantrenate, ale LLM-urilor și informațiile specifice și actuale de care depind majoritatea aplicațiilor reale. Astfel, dezvoltatorii și organizațiile pot construi soluții bazate pe AI mai inteligente, mai demne de încredere și cu adevărat utile, trecând de la proof-of-concept la aplicații gata de producție, care aduc valoare concretă.
Descoperă cum o strategie RAG îți poate îmbunătăți soluțiile bazate pe AI sau începe încă de azi să construiești cu RAG aplicații AI mai bine informate și mai demne de încredere. Drumul spre un AI mai factual și mai conștient de context este accelerat semnificativ de această abordare puternică.
Întrebări frecvente (FAQ) despre RAG LLM
Ce este RAG în LLM, pe înțelesul tuturor?
Gândește-te la un examen cu cartea deschisă pentru un LLM. În loc să se bazeze doar pe ce a „memorat” în timpul antrenării (adică foarte mult, dar nu întotdeauna actual sau suficient de specific), RAG îi permite LLM-ului să „caute” rapid informații relevante într-o „carte” specifică și actualizată (baza ta de cunoștințe externă) înainte să-ți răspundă la întrebare. Astfel, răspunsurile sale devin mult mai precise, mai actuale și mai relevante pentru nevoile tale specifice.
Cum îmbunătățește RAG acuratețea unui LLM?
RAG îmbunătățește acuratețea unui LLM furnizând, pentru fiecare interogare, informații factuale și relevante (regăsite din sursele tale de încredere) drept context. Acest lucru „ancorează” răspunsul LLM-ului în date verificabile și reduce semnificativ tendința lui de a ghici, de a inventa sau de a „halucina” răspunsuri. Eficiența acestui mecanism de ancorare în reducerea erorilor uzuale ale LLM-urilor și în creșterea încrederii utilizatorilor este bine documentată.
Este RAG mai bun decât fine-tuning-ul unui LLM?
Niciunul nu este „mai bun” în general; servesc unor scopuri diferite și, după cum am arătat în detaliu mai sus, pot fi chiar foarte complementare. RAG excelează la integrarea unor cunoștințe externe dinamice, factuale și extinse, care se schimbă des, și la indicarea surselor. Fine-tuning-ul este mai potrivit pentru adaptarea stilului și tonului unui LLM sau pentru a-l învăța sarcini specifice ori cunoștințe implicite care nu depind de o căutare externă. În multe scenarii, RAG folosit cu un model ajustat prin fine-tuning îmbină ce e mai bun din ambele lumi: un comportament adaptat și acces la date proaspete și specifice.
Care sunt cazurile de utilizare uzuale pentru RAG LLM?
Cazurile de utilizare uzuale pentru RAG LLM acoperă numeroase industrii și aplicații: • Chatboți de suport clienți care accesează manuale de produs, ghiduri de depanare și FAQ-uri actuale pentru a oferi asistență precisă. • Sisteme interne de întrebări și răspunsuri peste baza de cunoștințe, prin care angajații găsesc rapid politicile companiei, documentația tehnică sau informații despre proiecte. • Instrumente de generare de conținut care trebuie să citeze date recente, surse specifice sau să respecte anumite constrângeri factuale. • Instrumente de analiză financiară care integrează date de piață la zi, rapoarte ale companiilor și raportări către autoritățile de reglementare. • Aplicații medicale care oferă profesioniștilor din sănătate informații bazate pe cele mai noi cercetări și ghiduri clinice (cu supraveghere umană obligatorie pentru deciziile critice). Aceste exemple arată versatilitatea RAG în scenarii care cer acuratețe și acces la date specifice și actuale.
Ce surse externe de cunoștințe poate folosi RAG?
În principiu, RAG poate folosi aproape orice sursă de date text care poate fi procesată și indexată. Aici intră o gamă largă de materiale: • Documente interne ale companiei: PDF-uri, documente Word, prezentări PowerPoint, pagini Confluence, site-uri SharePoint, Google Docs. • Site-uri și conținut web: articole, postări de blog, site-uri de știri (cu scraping și parsare adecvate). • Baze de date (SQL sau NoSQL) care conțin informații text sau metadate ce pot fi convertite în text. • Cataloage de produse, specificații tehnice și FAQ-uri. • Lucrări științifice, articole de cercetare și reviste academice. • Transcrieri din serviciul clienți, tichete de suport și articole interne din baza de cunoștințe. Esențial este ca datele să fie curate, relevante și bine structurate, pentru o regăsire eficientă.